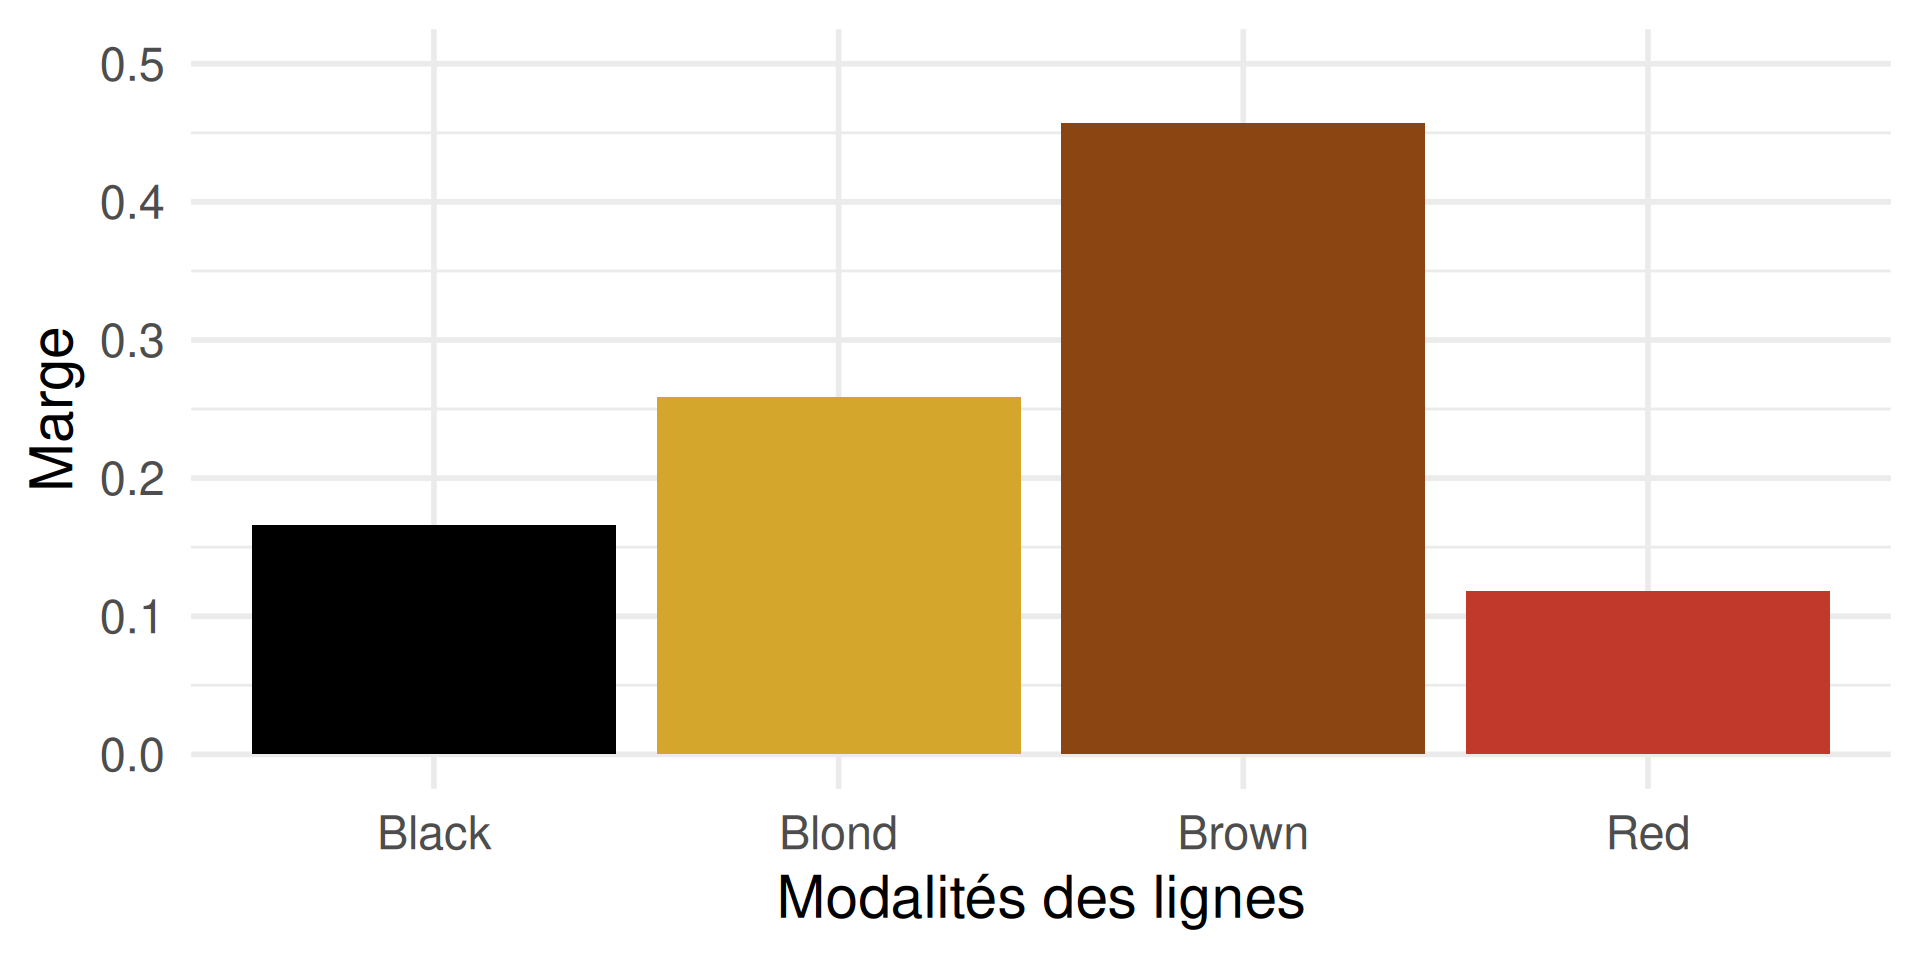
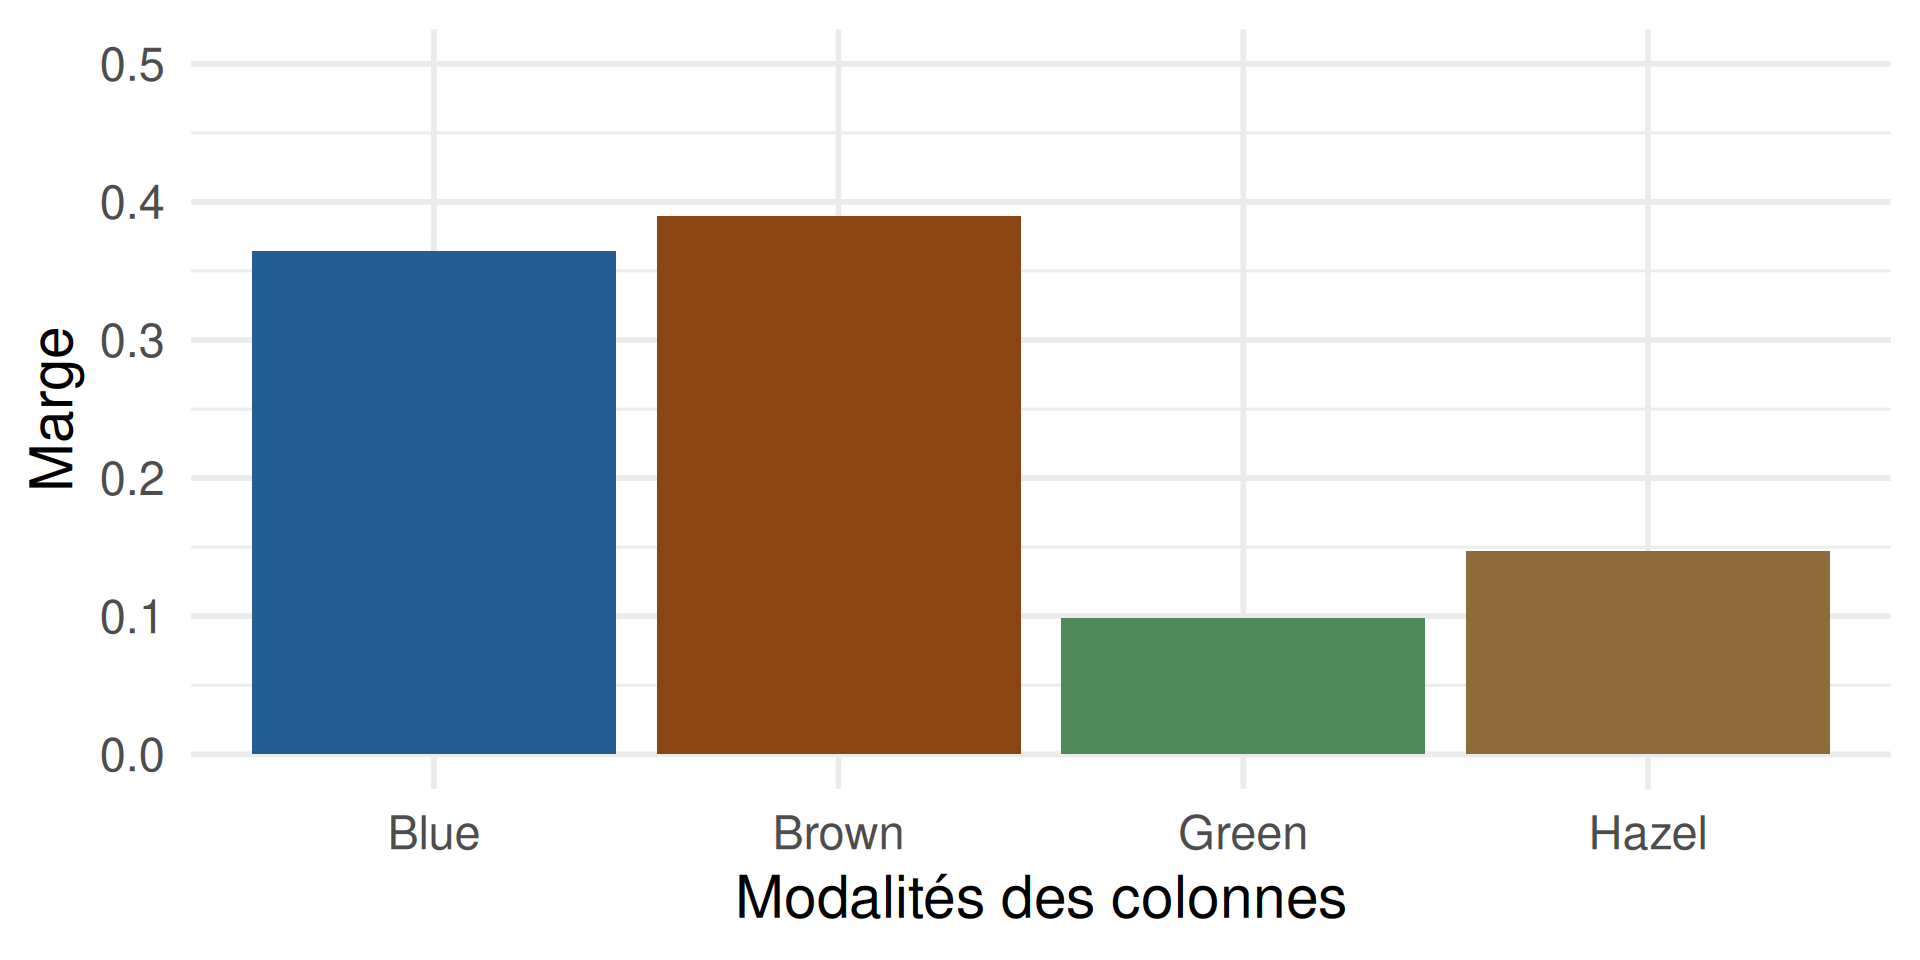
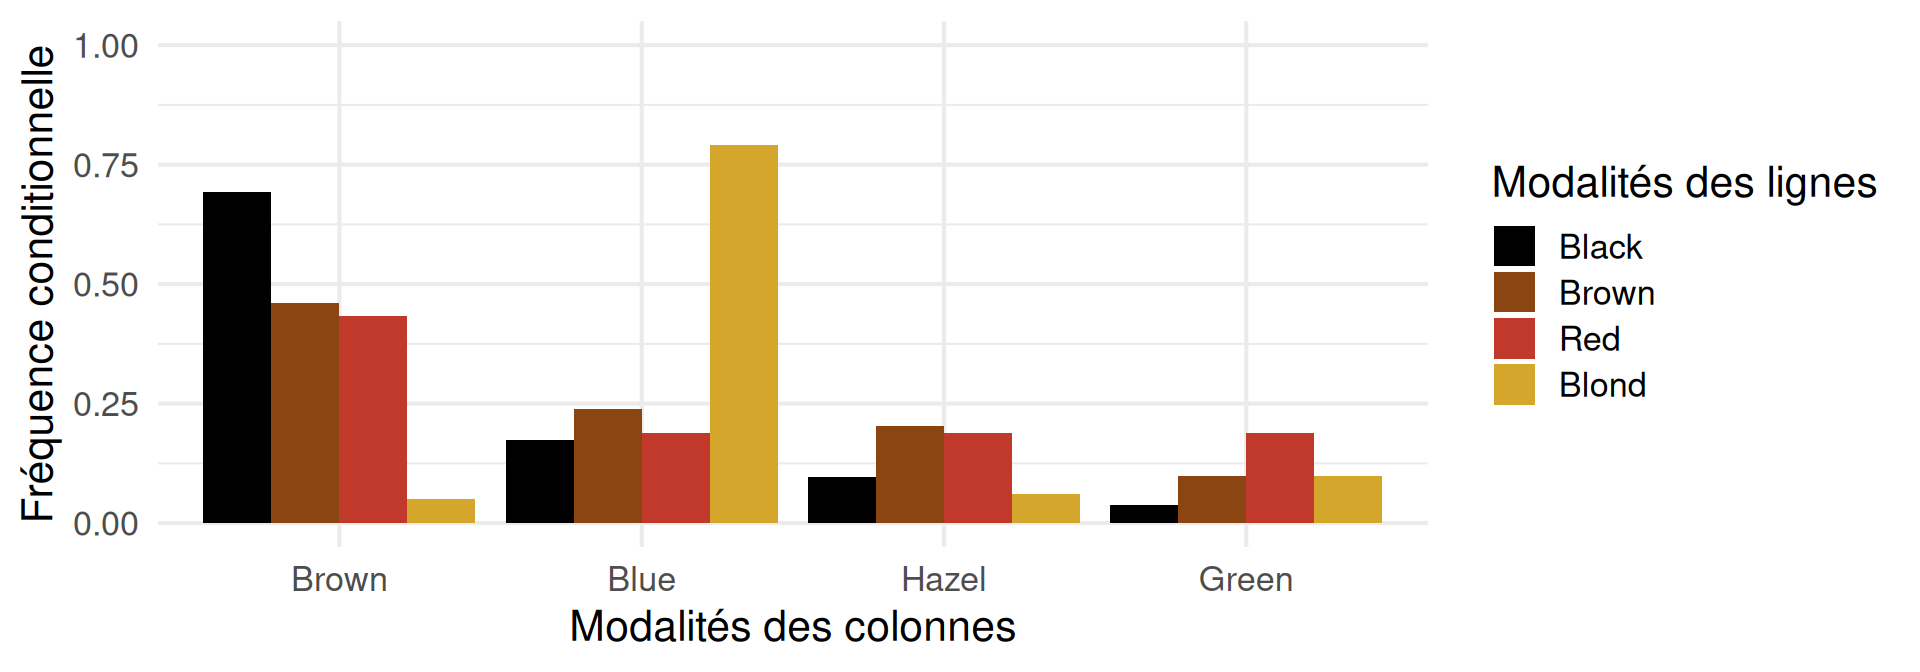
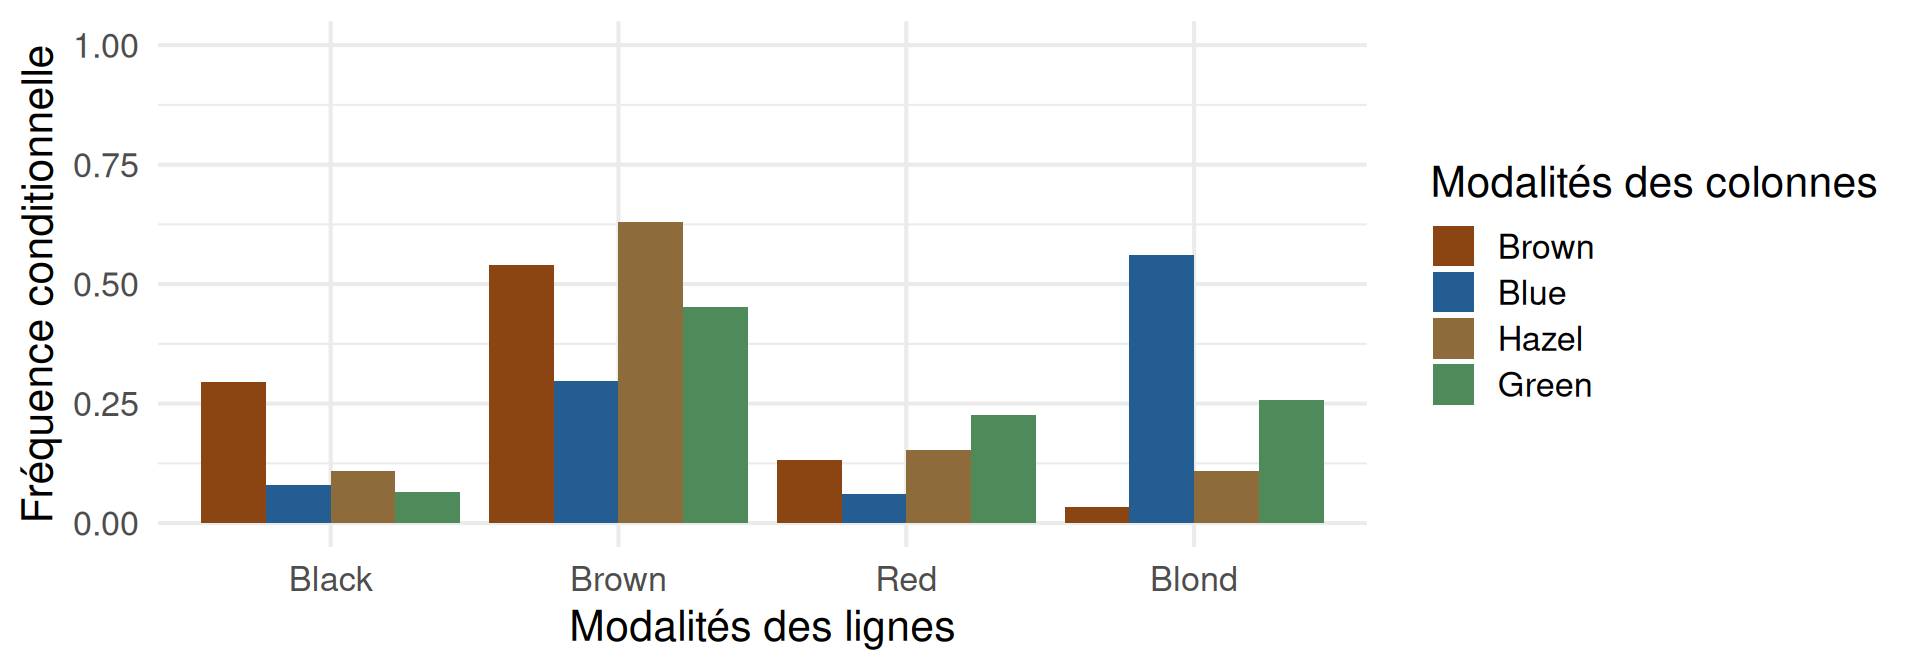
Un tableau de contingence est une matrice K \in \mathbb{R}^{q \times m} obtenue en croisant deux variables qualitatives X_1 et X_2, ayant respectivement q et m modalités, observées sur un échantillon de n individus.
Les fréquences et leurs marginales sont f_{is}=\frac{n_{is}}{n}, f_{i\cdot}=\sum_{s=1}^{m}f_{is}=\frac{n_{i\cdot}}{n}, f_{\cdot s}=\sum_{i=1}^{q}f_{is}=\frac{n_{\cdot s}}{n}.
On note ensuite les vecteurs des poids des lignes et des colonnes :
On note \ell_{is}=\tfrac{f_{is}}{f_{i\cdot}}=\tfrac{n_{is}}{n_{i\cdot}} le terme général de L =D_r^{-1}F.
Métrique des poids : les profils lignes forment un nuage de q vecteurs de \mathbb{R}^m. Le profil ligne moyen pondérés par D_r\in\mathbb{R}^{q\times q} (centre de gravité du nuage) est c=\sum_{i=1}^{q} f_{i\cdot}\, L_{i:} \in \mathbb{R}^m (marges des colonnes). On peut alors centrer la matrice des profils lignes1,
On note c_{is}=\tfrac{f_{is}}{f_{\cdot s}}=\tfrac{n_{is}}{n_{\cdot s}} le terme général de C=FD_c^{-1}.
Métrique des poids : les profils colonnes forment un nuage de m vecteurs de \mathbb{R}^q. Le profil colonne moyen pondérés par D_c\in\mathbb{R}^{m\times m} (centre de gravité du nuage) est r=\sum_{s=1}^{m} f_{\cdot s}\, C_{:s} \in\mathbb{R}^q (marges des lignes). On peut alors centrer la matrice des profils colonnes2:
C^c = \left(\tfrac{f_{is}}{f_{\cdot s}}-r_i \right)_{i,s}^{}
= \left(\tfrac{f_{is}}{f_{\cdot s}}-f_{i\cdot}\right)_{i,s}^{}
= \left(\tfrac{f_{is}-f_{i\cdot}f_{\cdot s}}{f_{\cdot s}}\right)_{i,s}^{}
= \left(F-r c^\top\right)D_c^{-1}.
Distance du \chi^2: métrique euclidienne avec poids D_r^{-1}\in \mathbb{R}^{q\times q}.
d^2_{D_r^{-1}}(C_{:s},C_{:s'})
=(C_{:s}-C_{:s'})^\mathsf{T}D_r^{-1}(C_{:s}-C_{:s'})
=\sum_{i=1}^{q}\tfrac{1}{f_{i\cdot}}
\left(\tfrac{f_{is}}{f_{\cdot s}}-\tfrac{f_{is'}}{f_{\cdot s'}}\right)^2.
2 Centrer dans cette métrique \sum_s f_{\cdot s}\, C^c_{:s} = 0_{\mathbb{R}^q} revient à mesurer l’écart à l’hypothèse d’indépendance stochastique (f_{is} = f_{i\cdot}f_{\cdot s}).
># Matrice des profils-colonnes C (distributions conditionnelles en colonne)>> C <-sweep(F,2,STATS=c,FUN="/")>round(C,digits=2)
       Eye
Hair    Brown Blue Hazel Green
  Black  0.30 0.08  0.11  0.06
  Brown  0.54 0.30  0.63  0.45
  Red    0.13 0.06  0.15  0.23
  Blond  0.03 0.56  0.11  0.26
avec les fréquences théoriques f_{i\cdot}f_{\cdot s} et les effectifs théoriques \frac{n_{i\cdot}n_{\cdot s}}{n}.
On définit une mesure locale de liaison entre une modalité i de X_1 et une modalité s de X_2 :
si f_{is}\simeq f_{i\cdot}f_{\cdot s}, il y a indépendance entre i et s ;
si f_{is}>f_{i\cdot}f_{\cdot s}, les modalités i et s s’attirent, car \tfrac{f_{is}}{f_{i\cdot}}>f_{\cdot s} et \tfrac{f_{is}}{f_{\cdot s}}>f_{i\cdot}
si f_{is}<f_{i\cdot}f_{\cdot s}, les modalités i et s se repoussent, car \tfrac{f_{is}}{f_{i\cdot}}<f_{\cdot s} et \tfrac{f_{is}}{f_{\cdot s}}<f_{i\cdot}
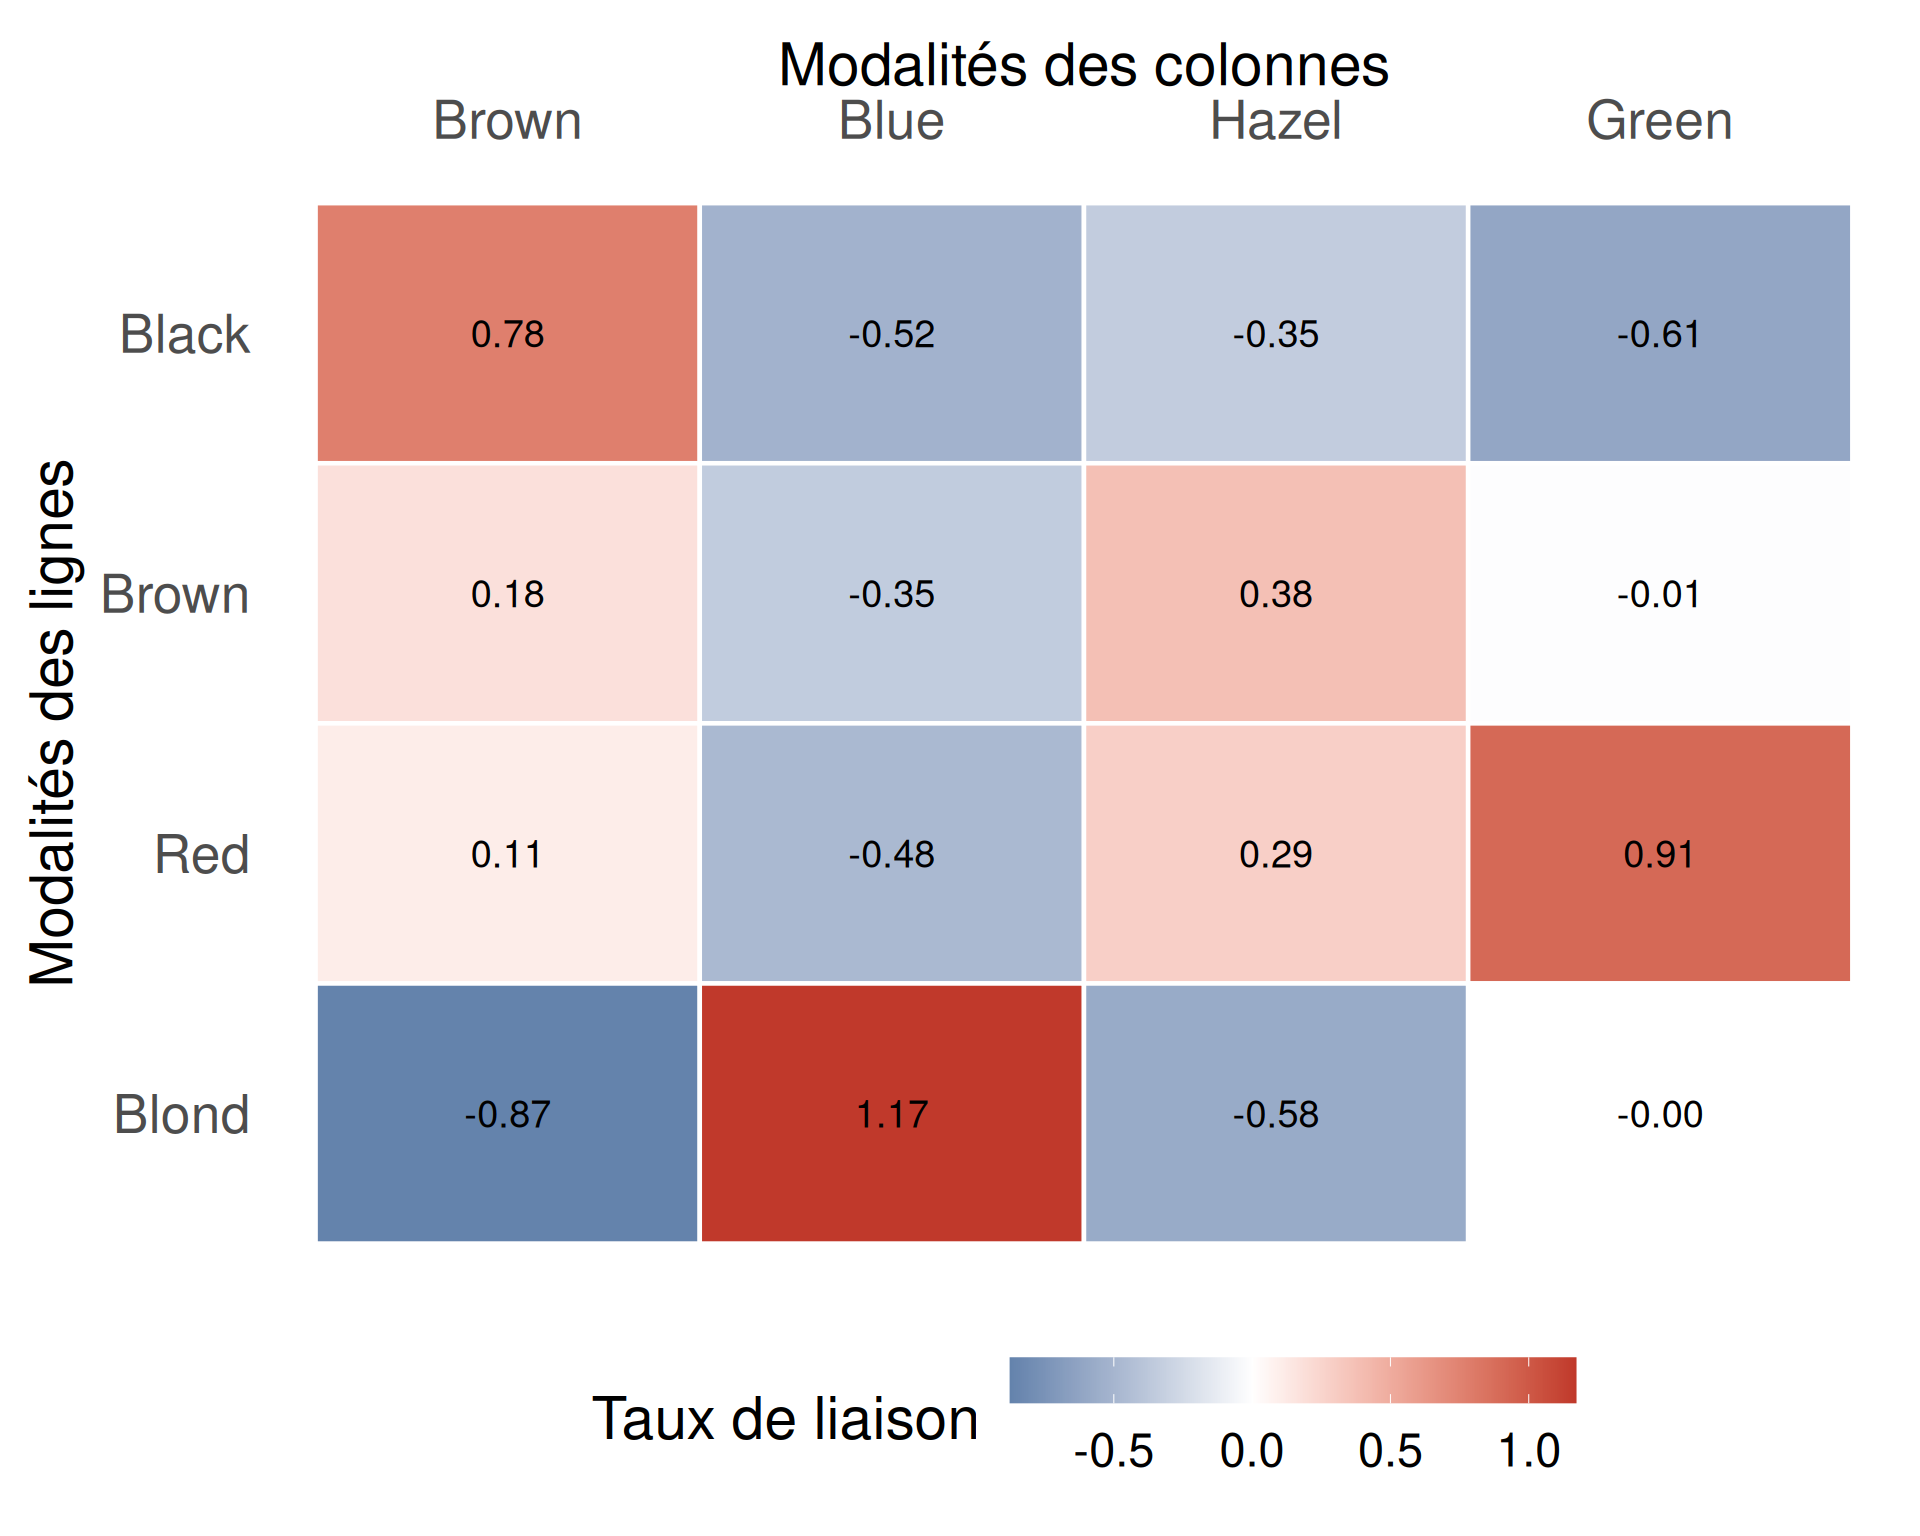
On a la matrice des écarts à l’indépendance (mesuré avec le taux de liaison):
Z = \left(\frac{f_{is}-f_{i\cdot}f_{\cdot s}}{f_{i\cdot}f_{\cdot s}}\right)_{is} = D_r^{-1} (F - rc^\top)D_c^{-1}
Matrice des taux de liaisons :
> Z <- (F-r%*%t(c))/(r%*%t(c))
Sur cet exemple :
La fréquence des bruns aux yeux marron est 18% au-dessus de ce qu’elle serait s’il y avait indépendance entre les deux variables couleurs des yeux et couleur des cheveux. De plus ces deux modalités s’attirent (le vérifier sur les tableaux de profils ligne et colonne).
La fréquence des blonds aux yeux marron est 87% au-dessous de ce qu’elle serait s’il y avait indépendance entre les deux variables. En plus ces deux modalités se repoussent (le vérifier sur les tableaux de profils ligne et colonne).
1.6 Inertie et liaison entre variables
Une mesure globale de liaison entre X_1 et X_2 est
\chi^2
=\sum_{i=1}^{q}\sum_{s=1}^{m}
\frac{\left(n_{is}-\tfrac{n_{i\cdot}n_{\cdot s}}{n}\right)^2}
{\tfrac{n_{i\cdot}n_{\cdot s}}{n}}
=n\underbrace{\sum_{i=1}^{q}\sum_{s=1}^{m}\frac{\left(f_{is}-f_{i\cdot}f_{\cdot s}\right)^2}
{f_{i\cdot}f_{\cdot s}}}_{=\Phi^2}
En cas d’indépendance, on a \chi^2=\Phi^2=0.
En pondérant z_{is} par f_{i\cdot}f_{\cdot s}, on obtient \small\bar{z}=\sum_{i,s} f_{i\cdot}f_{\cdot s}z_{is}=0, et \small\operatorname{Var}(Z)=\sum_{i,s}f_{i\cdot}f_{\cdot s}z_{is}^2 =\frac{\chi^2}{n}=\Phi^2.
ImportantThéorème
On a
\tfrac{1}{n}\chi^2=I(L)=I(C),
où I(L) est l’inertie du nuage des profils lignes et I(C) l’inertie du nuage des profils colonnes, calculées avec leur métrique et distance du \chi^2 respective3.
3 On a donc I(L) = \sum_s f_{i\cdot} d^2_{D_c^{-1}}(L_{i:}, c^\top) et I(C) = \sum_i f_{\cdot s} d^2_{D_r^{-1}}(C_{:s}, c^\top)
1.7 Exemple
># Statistique du chi2 calculée directement>chisq.test(K)$statistic
X-squared
 106.6637
># Carré de la distance du chi2 entre un profil ligne et le profil moyen> distsq <-function(x, mean=c) {+sum((x - mean)^2/ mean)+ }>># Carrés des distances de tous les profils lignes au profil moyen> dists.row <-apply(L, 1, distsq, mean = c)> dists.row
     Black      Brown        Red      Blond
0.38974635 0.07834092 0.18296344 0.84474722
># Inertie du nuage des profils lignes : moyenne ponderée des distances> iner.row <-sum(dists.row * r)> iner.row *sum(K)
[1] 106.6637
># Carrés des distances de tous les profils colonnes au profil moyen> dists.col <-apply(C, 2, distsq, mean = r)> dists.col
    Brown      Blue     Hazel     Green
0.3143532 0.4820014 0.1826037 0.1601520
># Inertie du nuage des profils colonnes : moyenne ponderée des distances> iner.col <-sum(dists.col * c)> iner.col *sum(K)
[1] 106.6637
2 Analyse Factorielle des Correspondances
2.1 Principes
Décrire simultanément les deux nuages pondérés suivants :
les q profils lignes (lignes de L) pondérés par D_r et avec la métrique D_c^{-1} ;
les m profils colonnes, (colonnes de C) pondérés par D_c et avec la métrique D_r^{-1}.
Elle revient de manière équivalente à effectuer :
deux ACP pondérées successives sur les q profils lignes, puis sur les m profils colonnes
ou une ACP pondérée du tableau des écarts à l’indépendance Z=D_r^{-1}(F-rc^\top)D_c^{-1} avec les pondérations D_r pour les lignes et D_c pour les colonnes.
2.2 ACP de la matrice des profils-lignes centrés
On cherche à représenter au mieux les q modalités de X_1 dans un sous-espace de \mathbb{R}^m de dimension k \le \min(q-1,m-1)4.
4 On a au plus q-1 dimensions pour les lignes (du fait du centrage par les poids) et m-1 pour les colonnes (car la somme d’un profil vaut 1).
Les axes sont engendrés par les vecteurs propres ordonnés v_1,\dots,v_k de L^\top D_r L D_c^{-1} \in \mathbb{R}^{m\times m} associés aux valeurs propres \lambda_1 \ge \dots \ge \lambda_k
À chaque étape, on ajoute une nouvelle direction qui maximise la variance (pondérée par D_r) des projections des profils-lignes centrés, sous la métrique D_c^{-1}
Les vecteurs directeurs v_\alpha sont D_c^{-1} orthonormés :
La matrice q \times k des coordonnées des profils-lignes projetés sur \text{Vect}(v_1, \dots, v_k) est notée :
X = L D^{-1}_c V_k
X_{:\alpha} est la \alpha-ième composante principale des profils-lignes, de moyenne nulle (\overline{X}_{:\alpha} = 0) et de variance \operatorname{Var}(X_{:\alpha}) = \lambda_\alpha.
2.3 ACP de la matrice des profils-colonnes centrés
De façon duale, on représente les m modalités de X_2 dans un sous-espace de \mathbb{R}^q de dimension k \le \min(q-1,m-1)5.
5 On a au plus q-1 dimensions pour les lignes (du fait du centrage par les poids) et m-1 pour les colonnes (car la somme d’un profil vaut 1).
Les axes sont engendrés par les vecteurs propres ordonnés u_1,\dots,u_k de C D_c C^\top D_r^{-1} \in \mathbb{R}^{q\times q} associés aux valeurs propres \lambda_1 \ge \dots \ge \lambda_k
À chaque étape, on ajoute une nouvelle direction qui maximise la variance (pondérée par D_c) des projections des profils-colonnes centrés, sous la métrique D_r^{-1}
Les vecteurs directeurs u_\alpha sont D_r^{-1}-orthonormés :
La matrice m \times k des coordonnées des profils-colonnes projetés sur \text{Vect}(u_1, \dots, u_k) est
Y = C^\top D^{-1}_r U_k
Y_{:\alpha} est la \alpha-ième composante principale des profils-colonnes, de moyenne nulle (\overline{Y}_{:\alpha} = 0) et de variance \operatorname{Var}(Y_{:\alpha}) = \lambda_\alpha.
2.4 SVD généralisée des taux de liaison
L’AFC peut se calculer par une décomposition en valeurs singulières (pondérée) de la matrice Z \in \mathbb{R}^{q\times m} (matrice des écarts à l’indépendance ou des profils centrés) avec les métriques
N = D_r^{-1} \in \mathbb{R}^{q\times q}
\qquad\text{et}\qquad
M = D_c^{-1} \in \mathbb{R}^{m\times m}.
On écrit alors
Z=U\Lambda V^\top,
où, en posant r=\operatorname{rang}(Z) :
\Lambda=\operatorname{diag}(\sqrt{\lambda_1},\ldots,\sqrt{\lambda_r}) est la matrice des valeurs singulières ordonnées ; les \lambda_\alpha sont les valeurs propres non nulles de ZMZ^\top N et de Z^\top NZM ;
U\in\mathbb{R}^{q\times r} contient en colonnes les vecteurs propres de ZMZ^\top N, orthonormés pour la métrique N : U^\top NU=I_r ;
V\in\mathbb{R}^{m\times r} contient en colonnes les vecteurs propres de Z^\top NZM, orthonormés pour la métrique M : V^\top MV=I_r.
Coordonnées factorielles: profils-lignes X et profils-colonnes Y)
\begin{cases}
X = Z M V_k = U_k \Lambda_k \\
Y = Z^\top N U_k = V_k \Lambda_k
\end{cases}
2.5 Calcul pratique à partir de la SVD standard
Calcul pratique (SVD standard) : Plutôt que d’utiliser les routines de SVD généralisée, on peut effectuer la SVD classique de \tilde{Z} = N^{1/2} Z M^{1/2} = \tilde{U} \tilde{\Lambda} \tilde{V}^\top (sous métriques identités I_q, I_m). On remonte ensuite aux facteurs par :
U = N^{-1/2} \tilde{U}, \qquad V = M^{-1/2} \tilde{V}, \qquad \Lambda = \tilde{\Lambda}
># On résout le problème généralisé : (Z M Z^T) u = lambda N^-1 u+# avec M = Dc^-1 et N^-1 = Dr+ M = np.diag(1.0/ c)+ N_inv = np.diag(r)++ A = Z @ M @ Z.T # Opérateur d'inertie+ B = N_inv # Métrique duale (Dr)++# eigh résout A u = lambda B u pour des matrices symétriques+ vals, U_gen = eigh(A, B)++# Tri par valeurs propres décroissantes+ idx = np.argsort(vals)[::-1]+ vals = vals[idx]+ U_gen = U_gen[:, idx]++# Coordonnées C_gen = U @ sqrt(Lambda)+ s_gen = np.sqrt(np.maximum(0, vals))+ C_gen = U_gen @ np.diag(s_gen)++print(np.round(np.abs(C_gen[:, :2]), 3)) # abs() car le signe est arbitraire
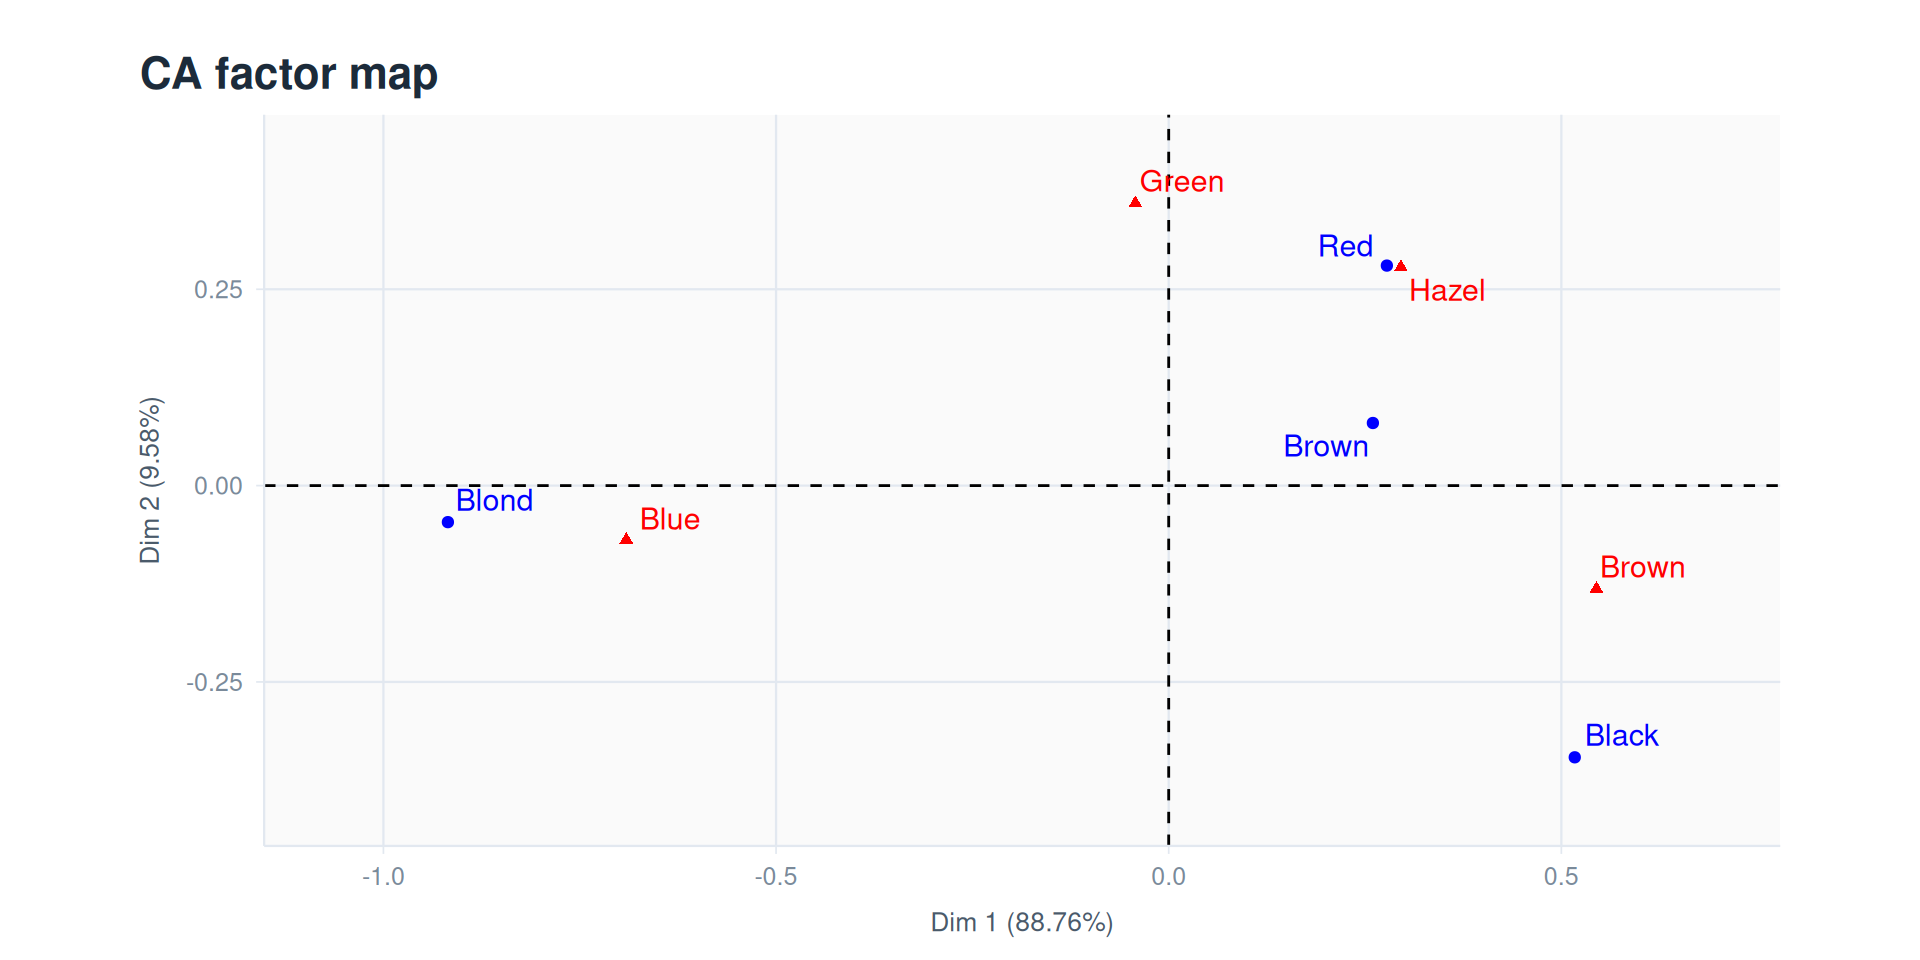
>library(FactoMineR)>># Exécution de l'AFC (CA = Correspondence Analysis)> res.ca <-CA(K, graph =TRUE)
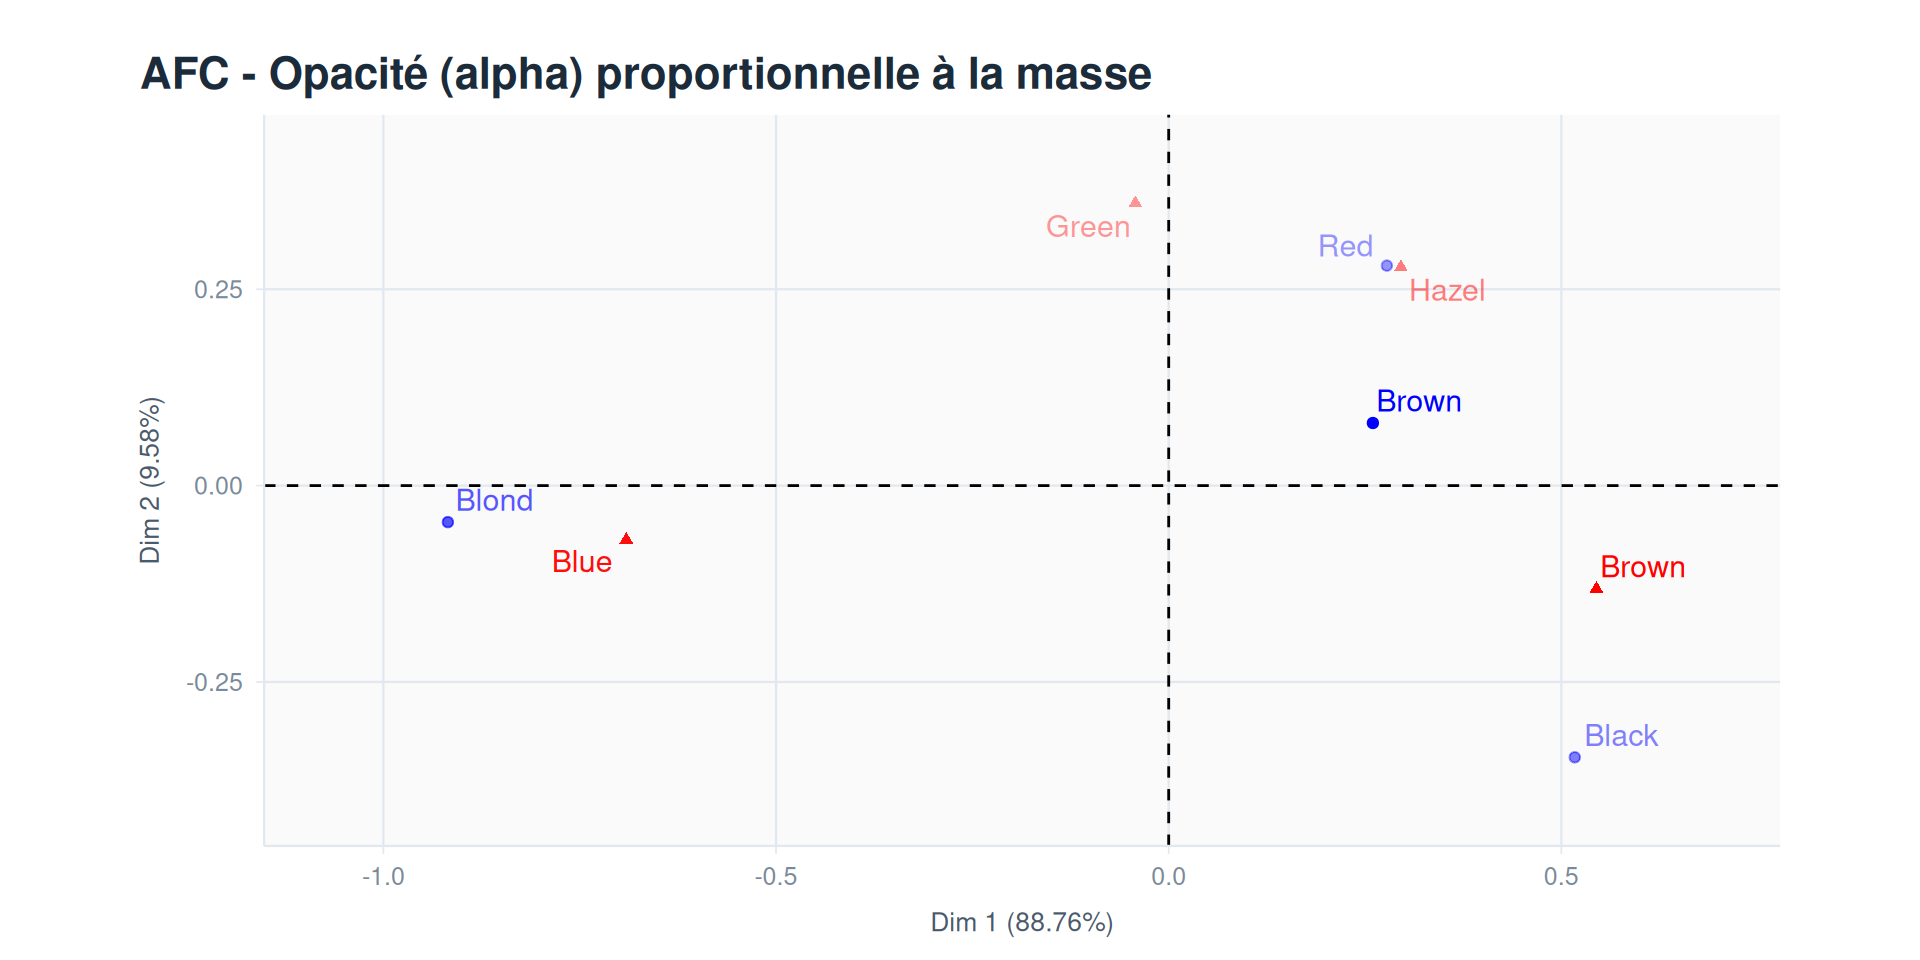
Axe 1 (inertie principale) : Oppose nettement les profils extrêmes sur la première dimension.
Côté lignes : opposition très marquée entre les cheveux Blond (à gauche) et Black / Brown (à droite).
Côté colonnes : opposition symétrique entre les yeux Blue (à gauche) et Brown (à droite).
Axe 2 : Isole la modalité intermédiaire Red (lignes) et Hazel / Green (colonnes).
2.7 Composante principale standardisée
Une composante principale standardisée est une composante divisée par son écart-type (\sqrt{\lambda_\alpha}).
La matrice \Lambda_k étant la matrice diagonale des valeurs singulières, les matrices X^* et Y^* des coordonnées factorielles standardisées s’écrivent :
\begin{cases}
X = D_r^{-1} (F - r c^\top) Y^* \\
Y = D_c^{-1} (F - r c^\top)^\top X^*
\end{cases}
La coordonnée factorielle d’une modalité d’une variable est une combinaison linéaire des coordonnées factorielles (standardisées) des modalités de l’autre variable
On en déduit immédiatement que
X_{i\alpha} = \tfrac{1}{\sqrt{\lambda_\alpha}} \displaystyle\sum_{s=1}^m \frac{f_{is}}{f_{i\cdot}} Y_{s\alpha} \qquad \text{ et } \qquad
Y_{s\alpha} = \tfrac{1}{\sqrt{\lambda_\alpha}} \displaystyle\sum_{i=1}^q \frac{f_{is}}{f_{\cdot s}} X_{i\alpha}
AstuceInterprétation géométrique et statistique
Principe du barycentre : La coordonnée de la modalité i est la moyenne des coordonnées (standardisées) des modalités s de l’autre variable, pondérée par les fréquences conditionnelles f_{is} / f_{i\cdot} (profil-ligne).
Dilatation : Au coefficient de dilatation 1/\sqrt{\lambda_\alpha} près (puisque \sqrt{\lambda_\alpha} < 1), les coordonnées factorielles d’un nuage de points sont, sur chaque axe, les barycentres des coordonnées factorielles de l’autre nuage.
Représentation simultanée : Ces relations justifient le tracé des profils-lignes et des profils-colonnes sur le même graphique (biplot). Mais Attention : la distance entre un profil-ligne et un profil-colonne ne s’interprète pas directement en termes de distance géométrique, mais en termes d’attraction/liaison (un profil-ligne se rapproche des profils-colonnes pour lesquels sa fréquence conditionnelle est élevée).
2.9 Exemple
Vérification des relations barycentriques sur le 1er axe
FactoMineR (x1)                          : 0.5170739
Formule avec y  (1/sqrt(lambda) * sum)   : 0.5170739
3 Interprétation et critères de qualité
3.1 Interprétation : Inertie et test d’indépendance
En ACP normée, l’inertie totale du nuage des points-individus est égale à p, le nombre de variables. En AFC, l’inertie totale des profils-lignes et des profils-colonnes est égale au \phi^2 (le \chi^2 d’indépendance divisé par l’effectif total n) :
I(L) = I(C) = \frac{\chi^2(X_1, X_2)}{n}
La dispersion des nuages de points est donc une mesure de liaison entre les deux variables qualitatives, appelée aussi mesure d’écart à l’indépendance.
Nombre d’axes et inertie : En AFC, il y a au plus r = \min(q - 1, m - 1) valeurs propres non nulles. L’inertie totale s’écrit \sum_{\alpha=1}^r \lambda_\alpha. Chaque axe principal explique une part de cette inertie :
\frac{\lambda_\alpha}{\lambda_1 + \dots + \lambda_r} \times 100
qui s’interprète comme :
Le pourcentage d’inertie (ou de variance) expliqué par l’axe \alpha,
La part de la liaison entre X_1 et X_2 captée par cet axe.
3.2 L’AFC en pratique
Test préalable du \chi^2
L’inertie totale vaut I = \frac{\chi^2}{n}.
AFC pertinente uniquement si H_0 est rejetée (p < 0{,}05).
Évite d’interpréter le bruit d’échantillonnage.
Choix du nombre d’axes
Rang maximal : r = \min(q - 1,\, m - 1).
Critère du coude sur l’éboulis des valeurs propres.
Seuil de Benzécri : conserver les axes où \lambda_\alpha > \frac{1}{r}.
Rôle : Identifie les modalités responsables de la construction de l’axe \alpha (donne son sens à l’axe).
Règle de décision : Une modalité est contributive si sa contribution excède le poids moyen : en lignes, si on a \operatorname{CTR}_\alpha(i) > \tfrac{1}{q}; en colonnes, si on a \operatorname{CTR}_\alpha(s) > \tfrac{1}{m}
AvertissementAttention au piège de l’excentrement
En AFC, un point très éloigné de l’origine n’est pas forcément un contributeur majeur : la contribution dépend du produit entre l’éloignement (X_{i\alpha}^2) et la masse de la modalité (f_{i\cdot}). Une modalité rare très excentrée peut avoir une contribution faible.
où d^2_{D_r^{-1}}(L_{i:}, c^\top) est la distance du \chi^2 entre le profil-ligne L_{i:} et le profil moyen c.
Axe bien représenté : On n’interprète la position d’un point sur un axe que si son \cos^2_\alpha est élevé (proximité réelle, non un artefact de projection).
Proximité Intra-variable : Deux modalités d’une même variable proches et bien représentées ont des profils similaires.
Proximité Inter-variables : La proximité entre une modalité ligne et une colonne s’interprète uniquement via les relations barycentriques (attraction / liaison positive).