Code
> fname <- file.path(get_script_dir(), "data", "OECD.csv")
> df_raw <- read.csv(fname, stringsAsFactors = FALSE)On considère des données fournies par l’OCDE sur des indicateurs du « vivre mieux » (voir le site de l’OCDE). On se concentre sur les données de 16 pays concernant 22 indicateurs qui peuvent être répartis dans cinq grands domaines permettant de mesurer le « vivre mieux » :
Bien-être matériel : logements sans équipements sanitaires de base (HO_BASE), coût du logement (HO_HISH), nombre de pièces par personne (HO_NUMR), revenu disponible des ménages (IW_HADI), patrimoine financier des ménages (IW_HNFW) ;
Emploi : taux d’emploi (JE_EMPL), insécurité de l’emploi (JE_LMIS), taux de chômage de longue durée (JE_LTUR), revenus moyens d’activité (JE_PEARN), horaires de travail lourds (WL_EWLH) ;
Satisfaction : qualité du réseau social (SC_SNTWS), satisfaction à l’égard de la vie (SW_LIFS), temps consacré aux loisirs et à soi (WL_TNOW) ;
Santé et sécurité : pollution atmosphérique (EQ_AIRP), qualité de l’eau (EQ_WATER), espérance de vie (HS_LEB), auto-évaluation de l’état de santé (HS_SFRH), sentiment de sécurité seul la nuit (PS_FSAFEN), taux d’homicides (PS_REPH) ;
Enseignement : niveau d’instruction (ES_EDUA), compétences des élèves (ES_STCS), années de scolarité (ES_EDUEX).
On souhaite comparer le « vivre mieux » de ces 16 pays en prenant en compte l’ensemble des cinq grands domaines de mesure du « vivre mieux ».
> fname <- file.path(get_script_dir(), "data", "OECD.csv")
> df_raw <- read.csv(fname, stringsAsFactors = FALSE)> library(dplyr)
> library(tidyr)
>
> # Codes ISO des 16 pays de l'exercice
> codes_16 <- c("AUT", "BEL", "CAN", "FIN", "FRA", "DEU", "GRC", "HUN", "IRL", "ITA", "NLD", "NOR", "POL", "GBR", "USA", "EST")
>
> var22 <- c("HO_BASE", "HO_HISH", "HO_NUMR", "IW_HADI", "IW_HNFW", "JE_EMPL", "JE_LMIS", "JE_LTUR", "JE_PEARN", "WL_EWLH", "SC_SNTWS", "SW_LIFS", "WL_TNOW", "EQ_AIRP", "EQ_WATER", "HS_LEB", "HS_SFRH", "PS_FSAFEN", "PS_REPH", "ES_EDUA", "ES_STCS", "ES_EDUEX")
>
>
> # 1. Traitement et pivot
> ocde_16 <- df_raw %>%
+ filter(LOCATION %in% codes_16) %>%
+ filter(INDICATOR %in% var22) %>%
+ filter(MEASURE == "L" | INEQUALITY == "TOT") %>%
+ select(LOCATION, INDICATOR, OBS_VALUE) %>%
+ distinct(LOCATION, INDICATOR, .keep_all = TRUE) %>%
+ pivot_wider(names_from = INDICATOR, values_from = OBS_VALUE)
>
> # 2. Réordonner les colonnes selon var22 (en gardant les colonnes existantes)
> variables_presentes <- intersect(var22, names(ocde_16))
> ocde_16 <- ocde_16 %>%
+ select(LOCATION, all_of(variables_presentes))
>
> # 3. Passer LOCATION en rownames
> ocde_16 <- ocde_16 %>%
+ tibble::column_to_rownames("LOCATION")> library(FactoMineR)
>
> ocde.mfa <- MFA(
+ ocde_16,
+ group = c(5, 5, 3, 6, 3),
+ type = rep("s", 5),
+ name.group = c("Materiel", "Emploi", "Satisfaction", "Sante_Securite", "Enseignement"),
+ graph = FALSE
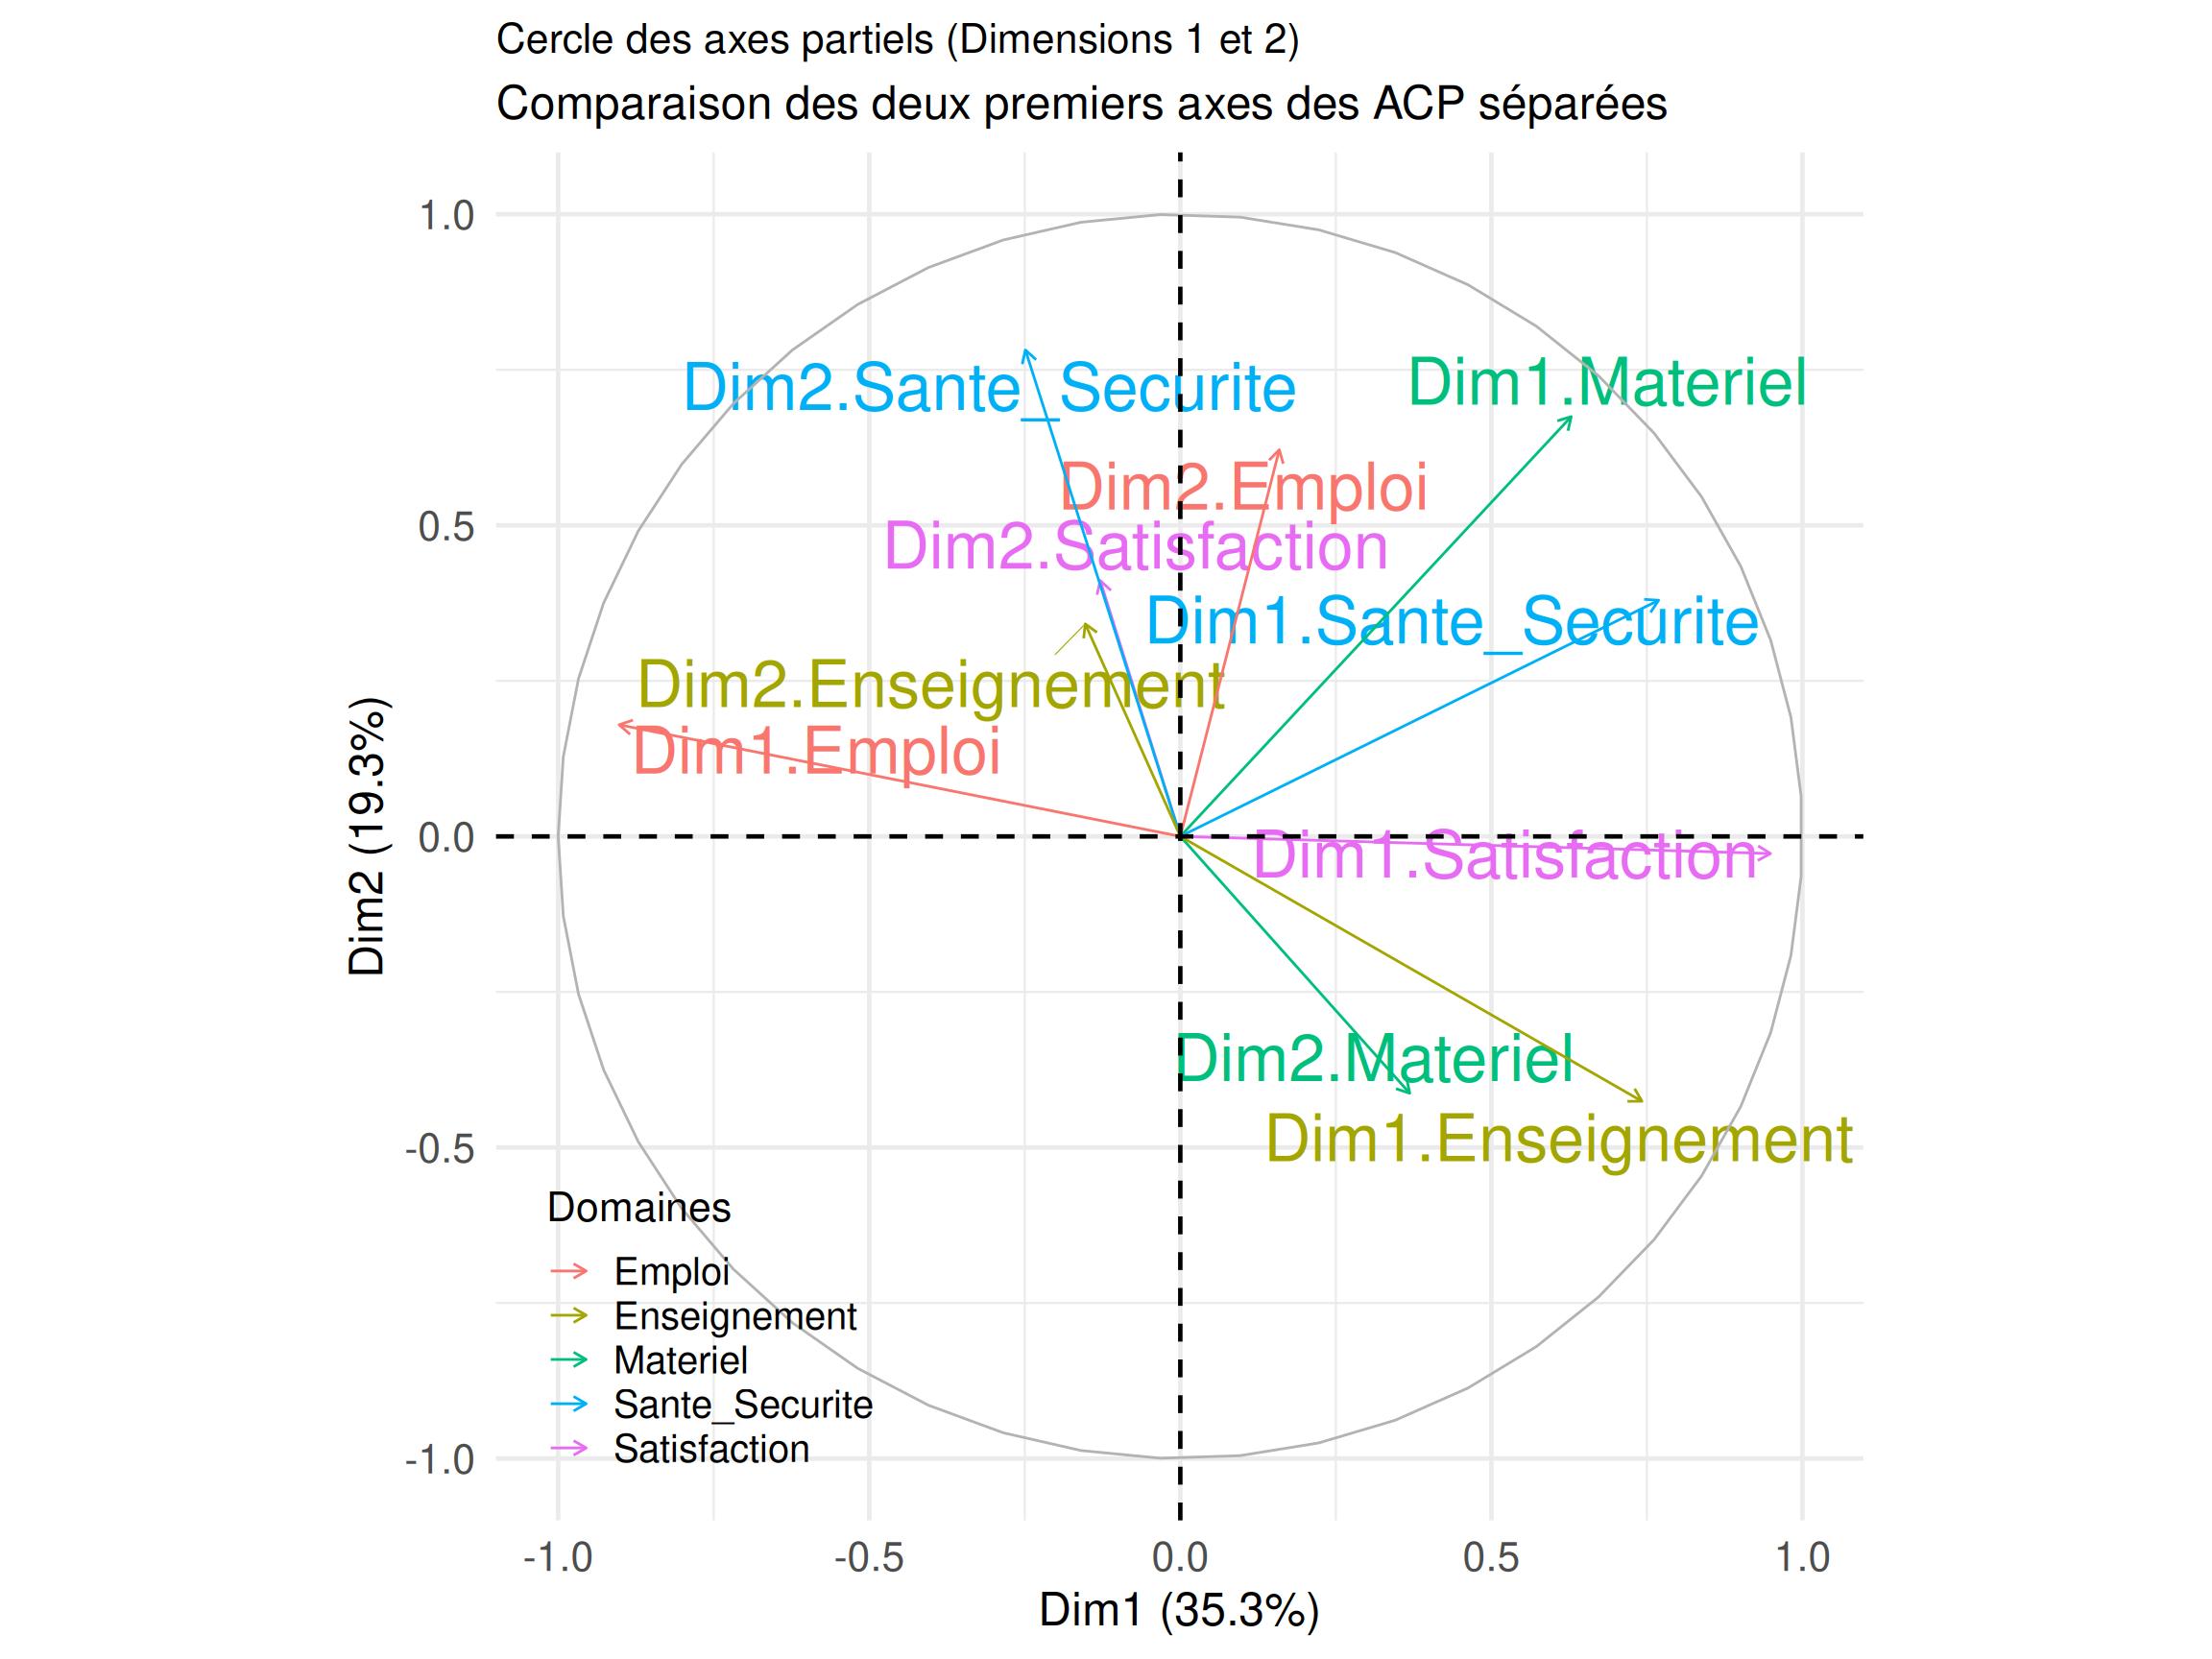
+ )Résumez la méthodologie de mise en œuvre de l’AFM pour étudier les individus et les variables.
On se concentre sur le premier plan factoriel. Les représentations des individus et des variables, ainsi que leurs cos2, sont données ci-dessous.
> print_table(ocde.mfa$ind$cos2[,1:2])| Dim.1 | Dim.2 | |
|---|---|---|
| AUT | 0.161 | 0.000 |
| BEL | 0.052 | 0.164 |
| CAN | 0.377 | 0.051 |
| FIN | 0.368 | 0.003 |
| FRA | 0.095 | 0.072 |
| DEU | 0.138 | 0.018 |
| GRC | 0.805 | 0.046 |
| HUN | 0.164 | 0.622 |
| IRL | 0.187 | 0.058 |
| ITA | 0.548 | 0.151 |
| NLD | 0.246 | 0.048 |
| NOR | 0.354 | 0.051 |
| POL | 0.088 | 0.622 |
| GBR | 0.040 | 0.027 |
| USA | 0.247 | 0.064 |
| EST | 0.017 | 0.655 |
> print_table(ocde.mfa$quanti.var$cos2[,1:2])| Dim.1 | Dim.2 | |
|---|---|---|
| HO_BASE | 0.023 | 0.763 |
| HO_HISH | 0.063 | 0.092 |
| HO_NUMR | 0.569 | 0.190 |
| IW_HADI | 0.454 | 0.304 |
| IW_HNFW | 0.223 | 0.216 |
| JE_EMPL | 0.443 | 0.217 |
| JE_LMIS | 0.663 | 0.029 |
| JE_LTUR | 0.741 | 0.120 |
| JE_PEARN | 0.529 | 0.344 |
| WL_EWLH | 0.007 | 0.094 |
| SC_SNTWS | 0.642 | 0.124 |
| SW_LIFS | 0.647 | 0.146 |
| WL_TNOW | 0.095 | 0.096 |
| EQ_AIRP | 0.419 | 0.089 |
| EQ_WATER | 0.738 | 0.003 |
| HS_LEB | 0.002 | 0.654 |
| HS_SFRH | 0.043 | 0.582 |
| PS_FSAFEN | 0.332 | 0.000 |
| PS_REPH | 0.068 | 0.004 |
| ES_EDUA | 0.390 | 0.263 |
| ES_STCS | 0.572 | 0.121 |
| ES_EDUEX | 0.001 | 0.043 |
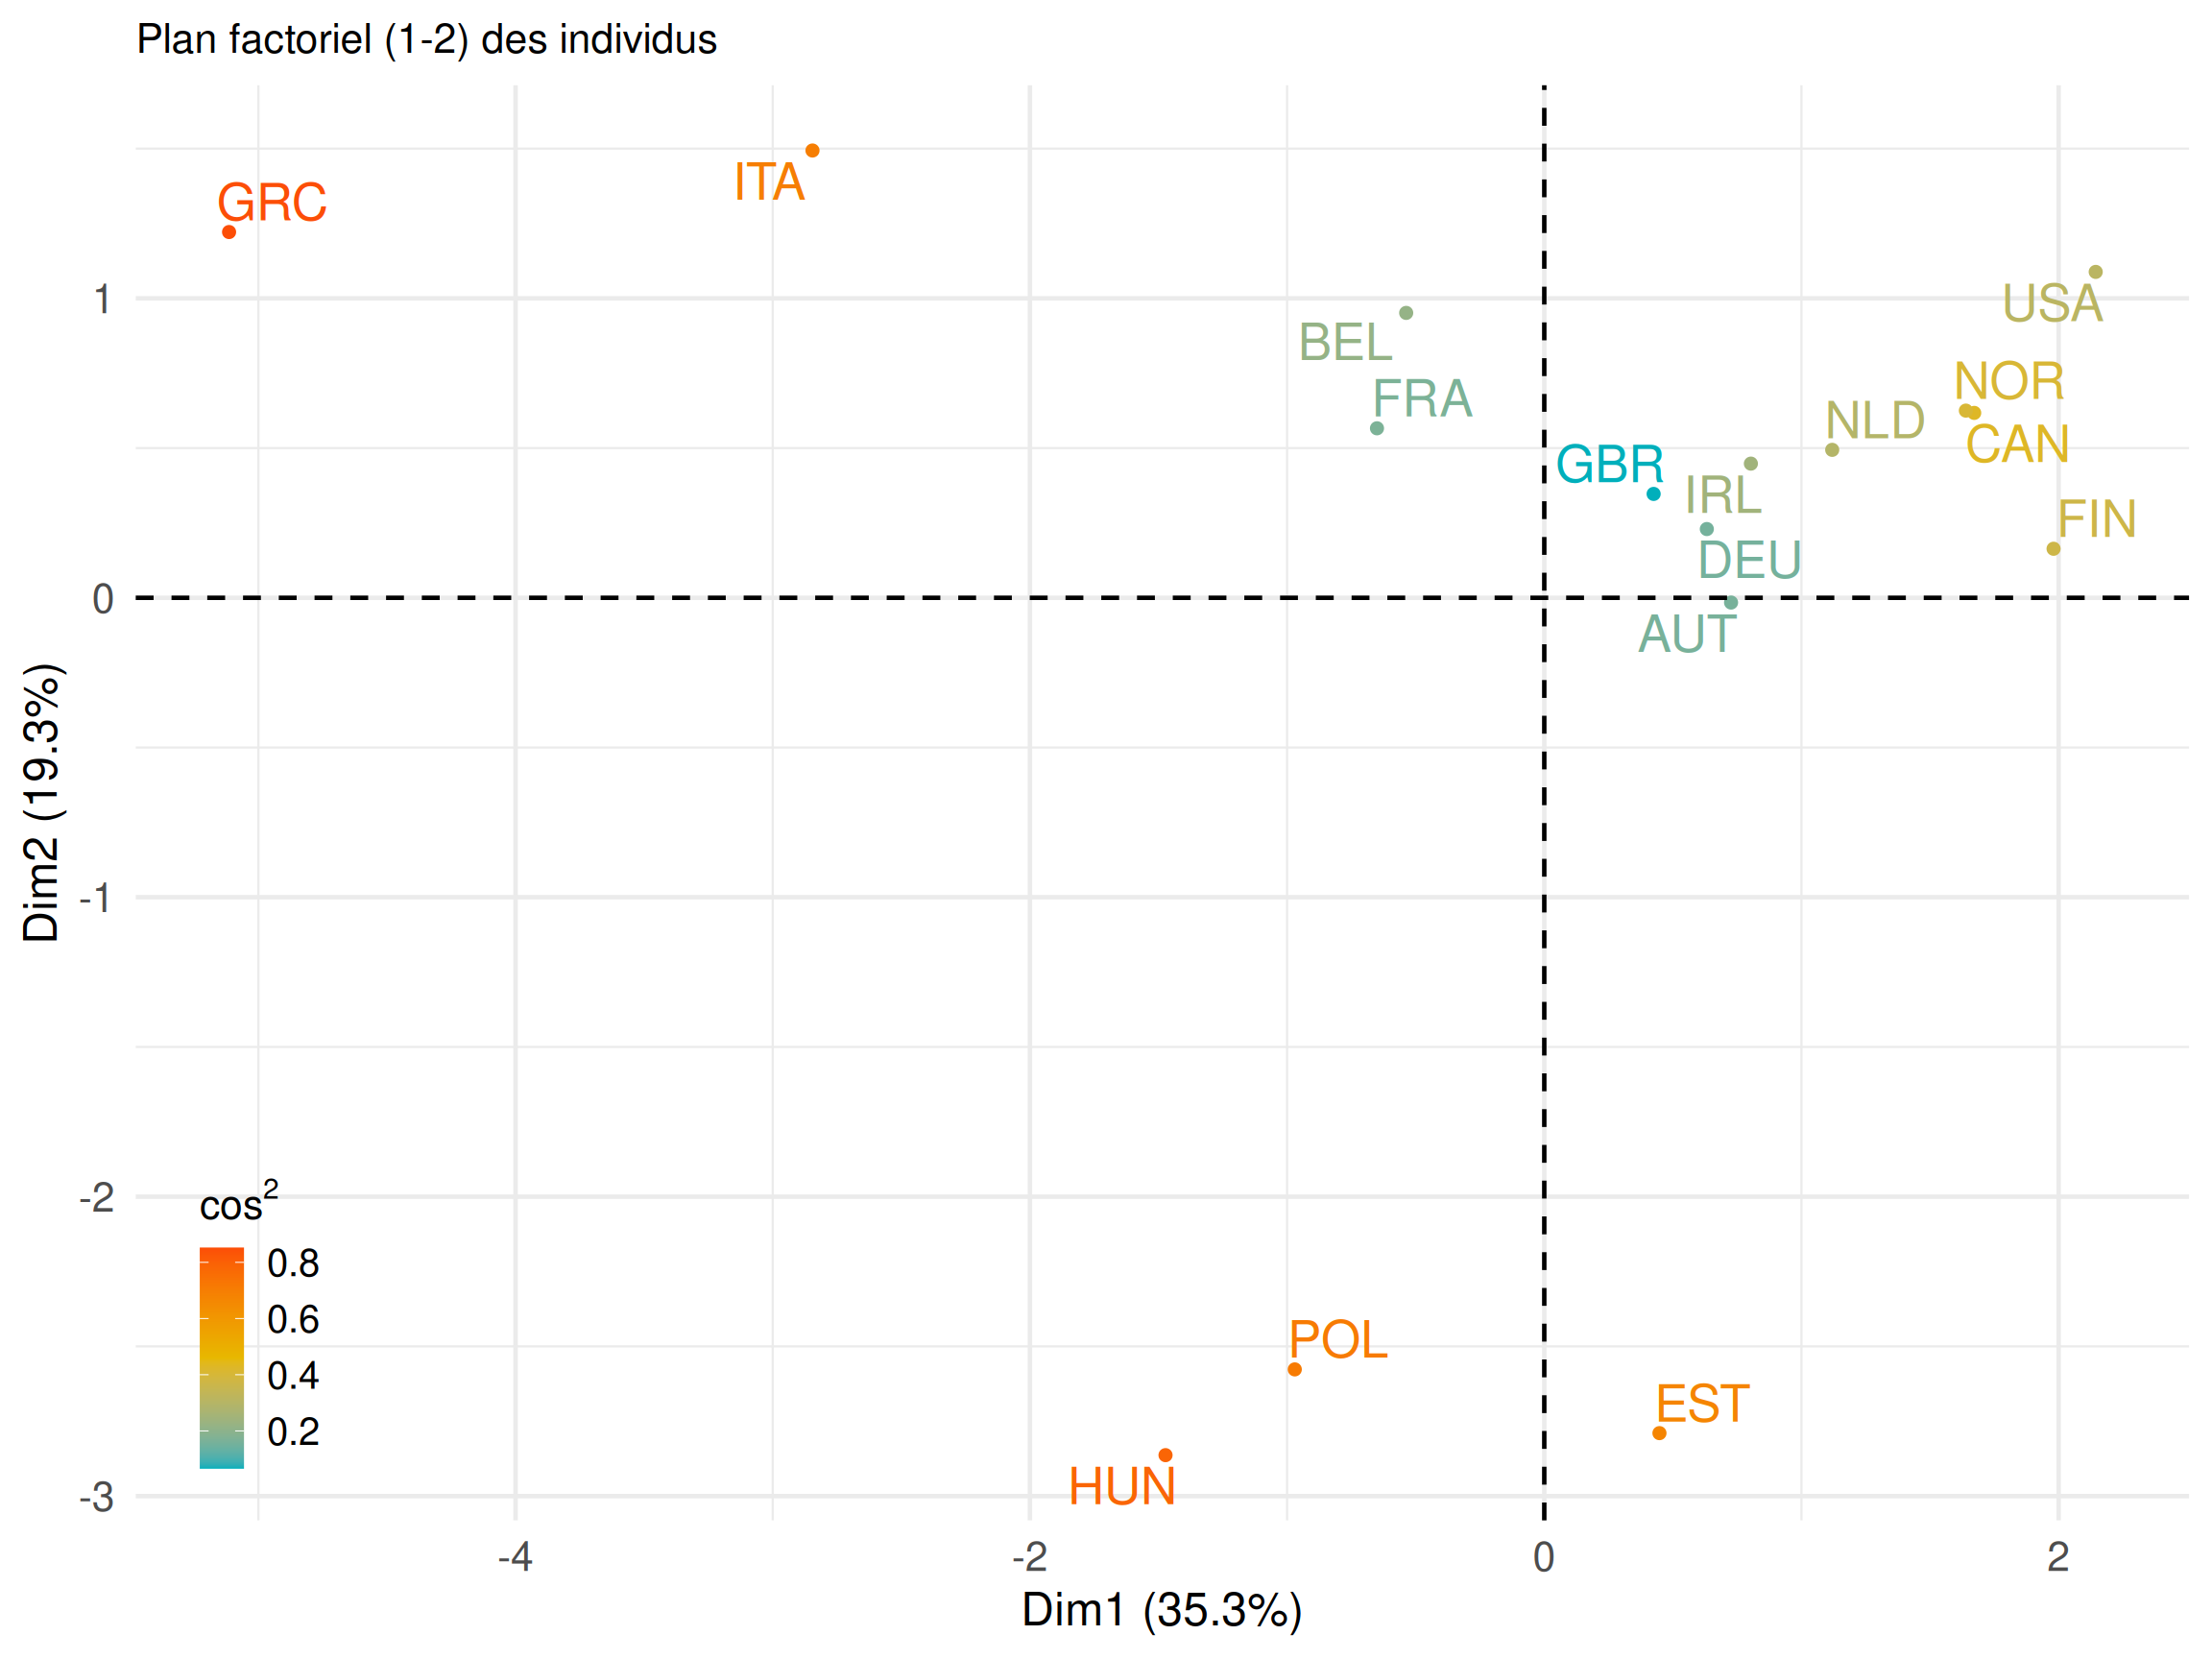
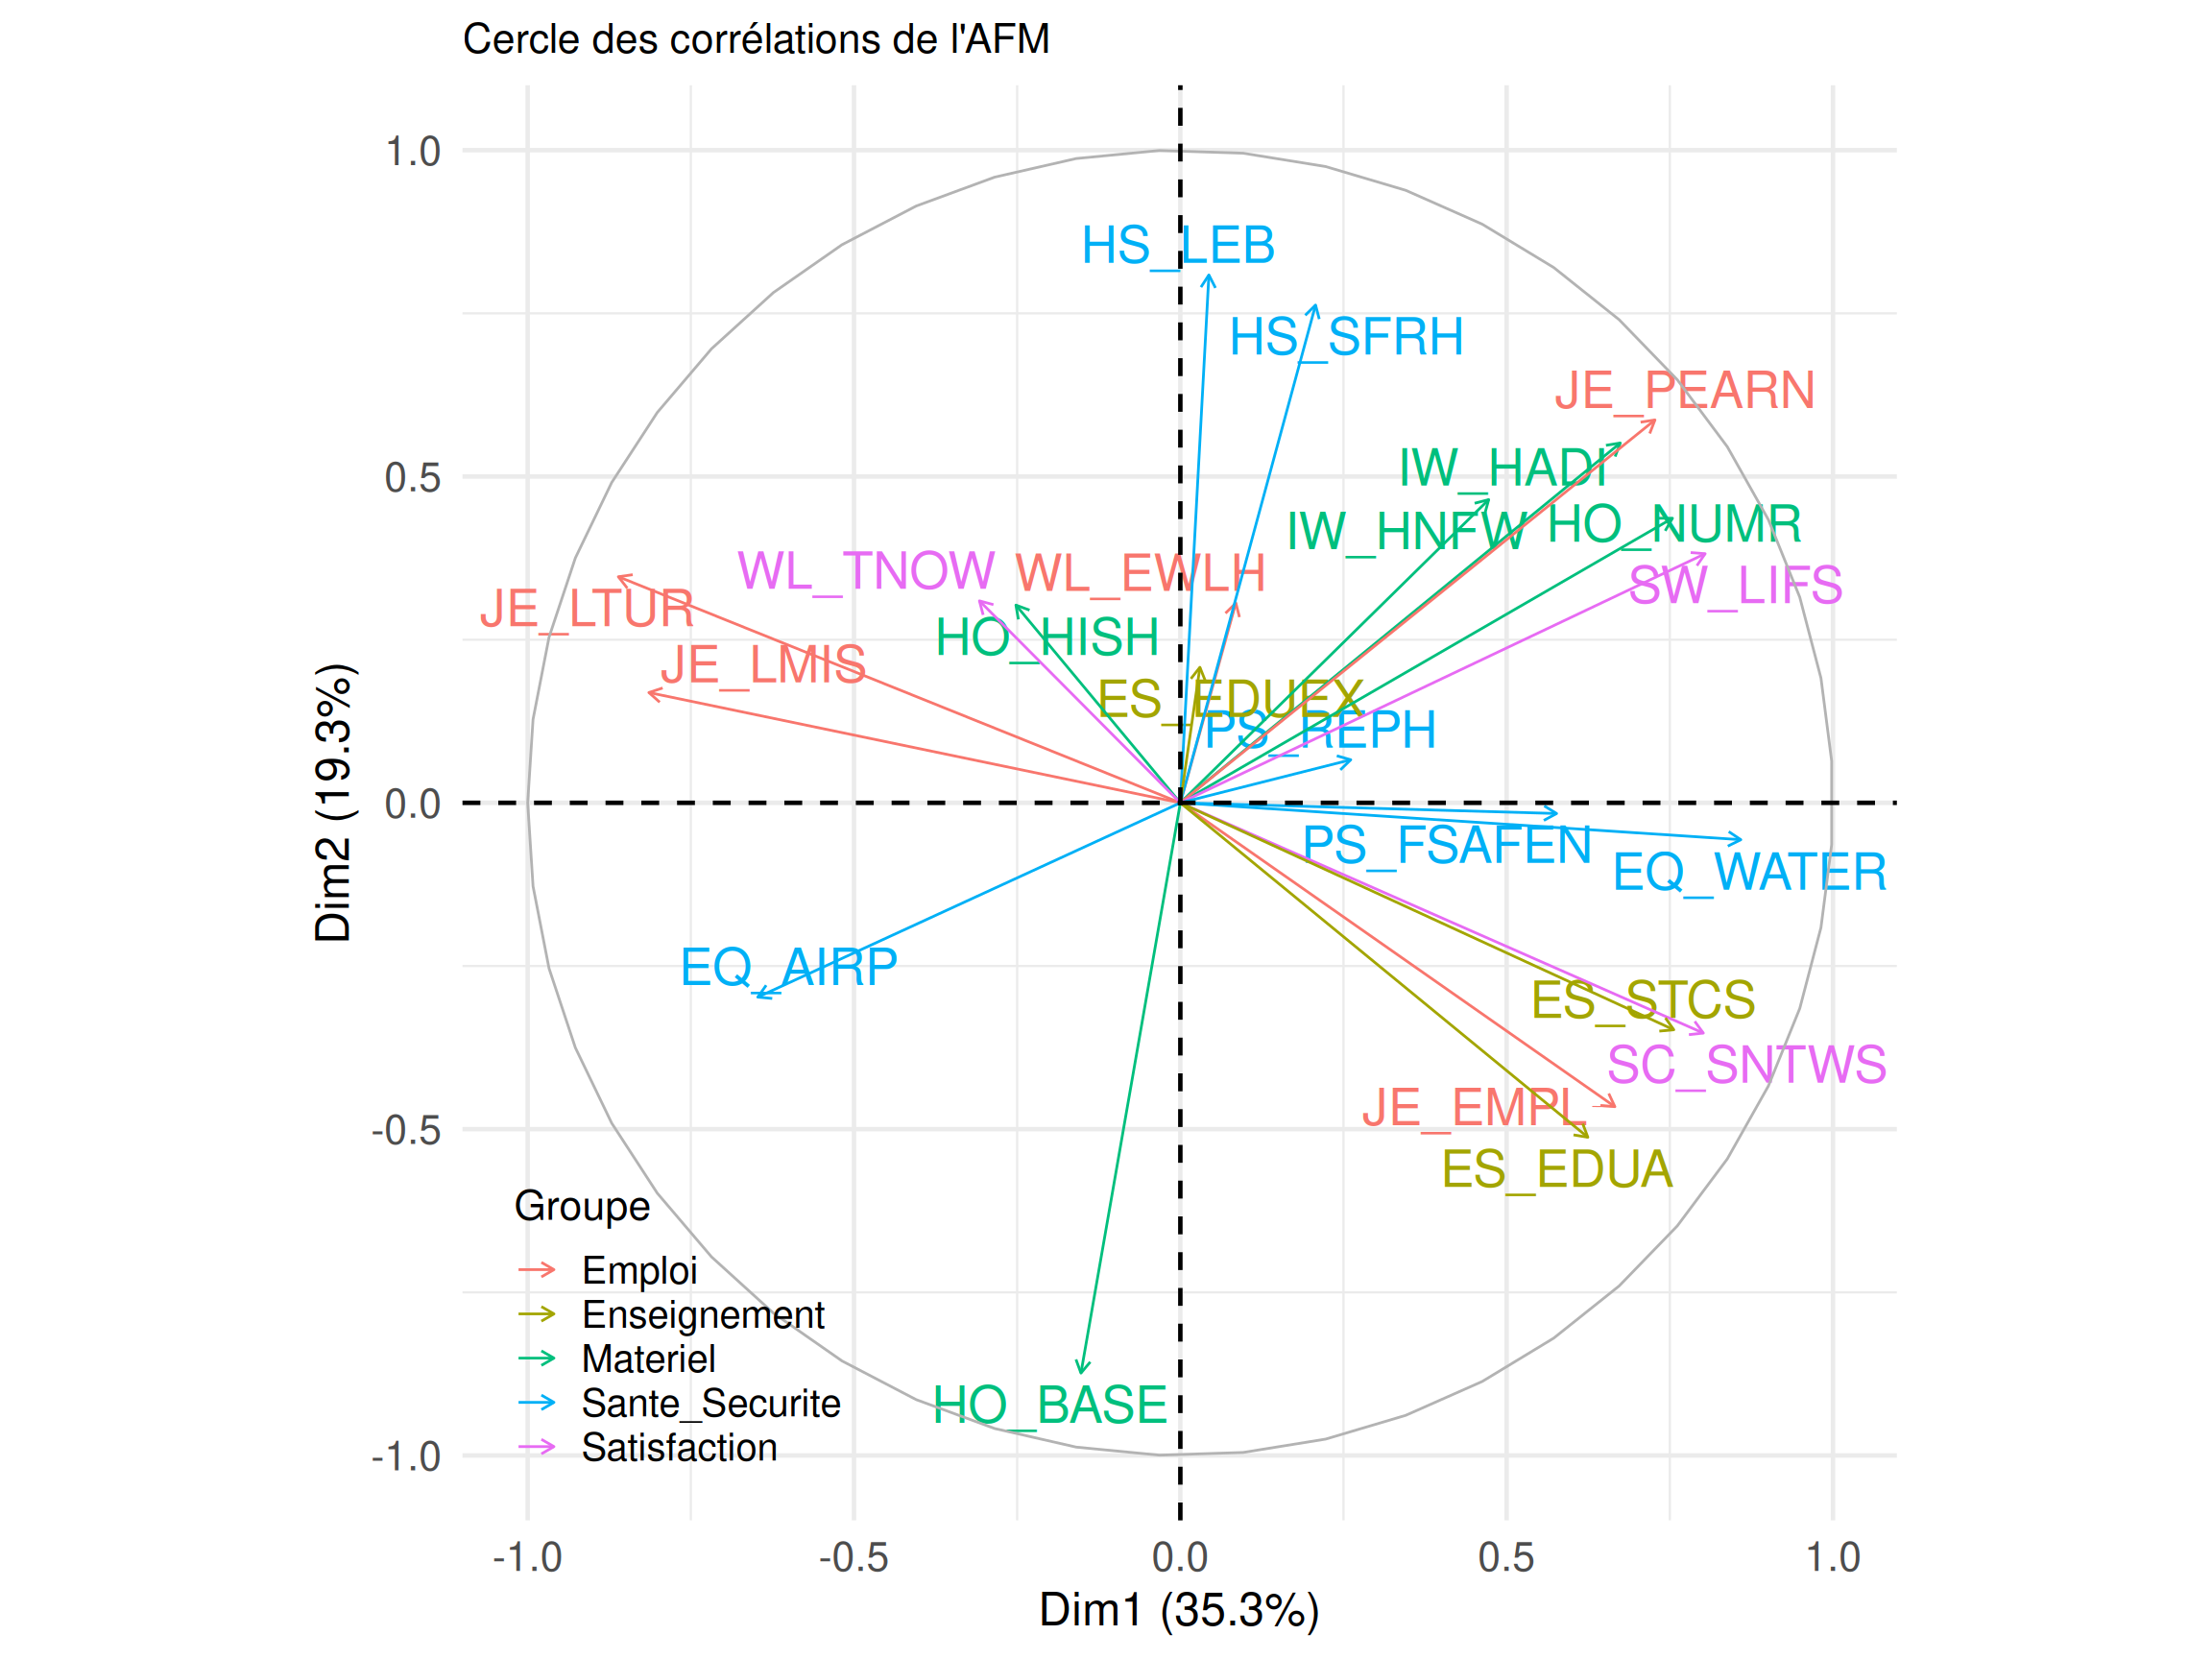
Faites une première interprétation des individus et des variables dans ce plan.
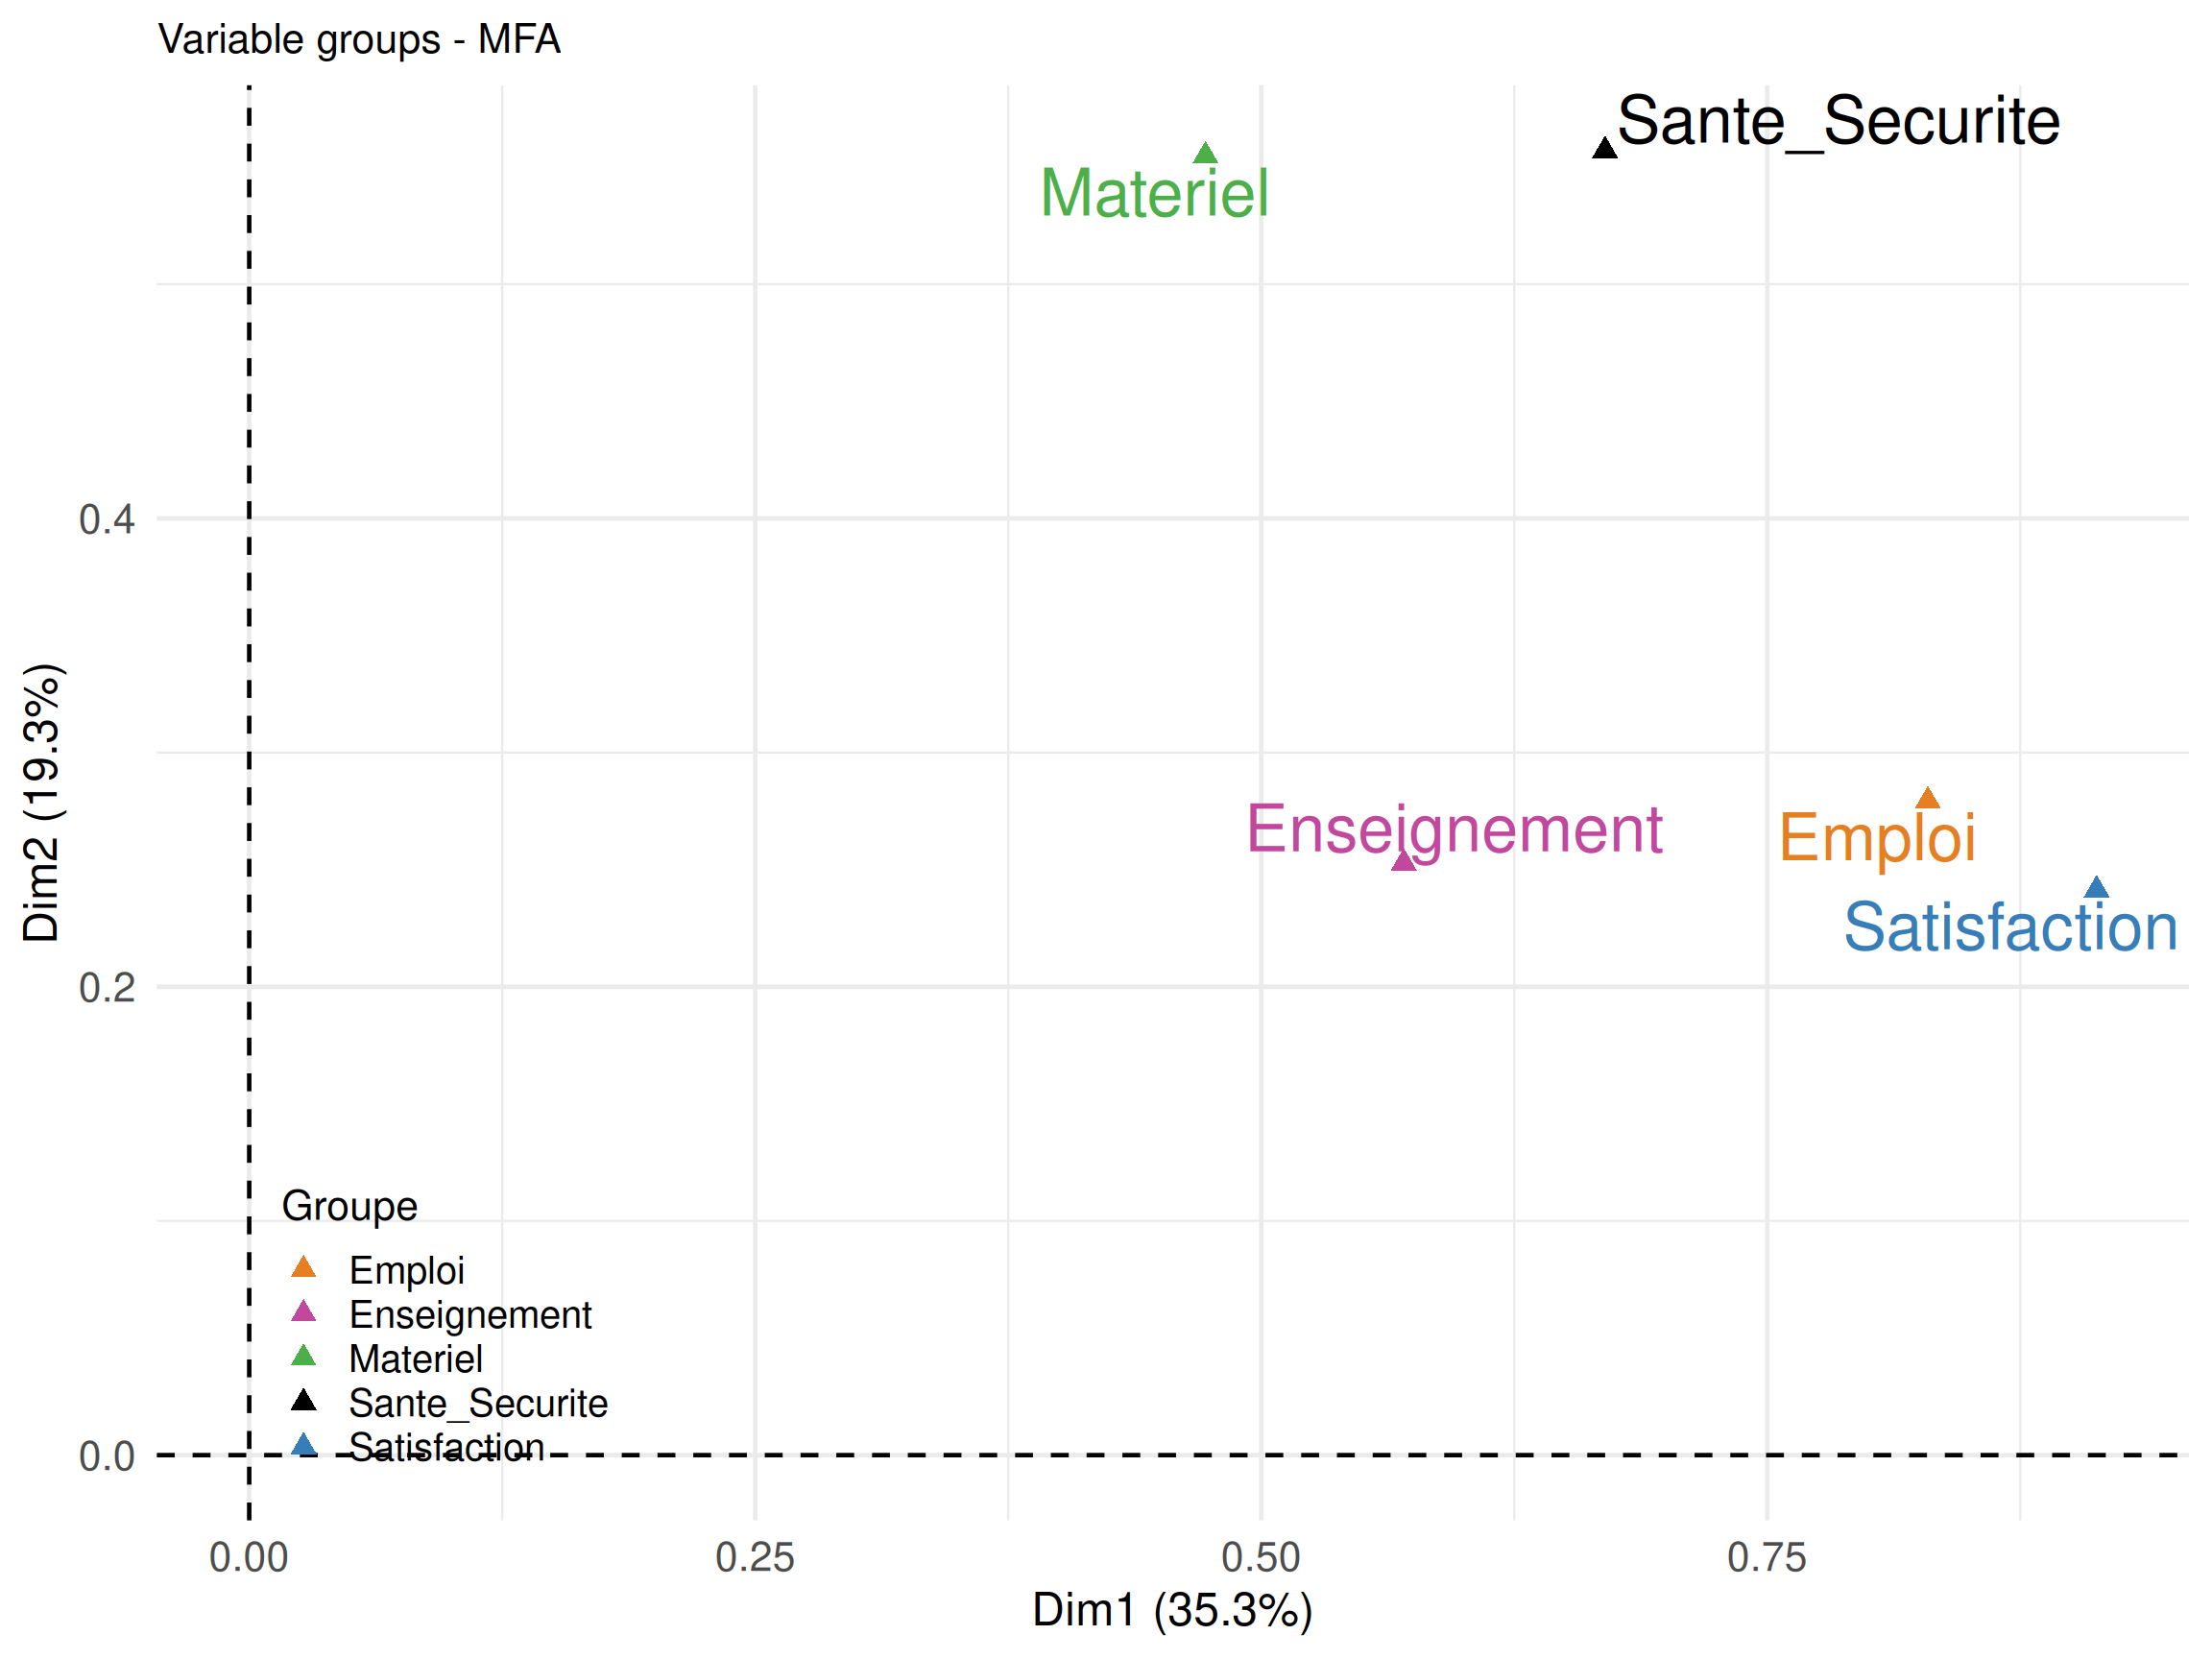
> print_table(diag(ocde.mfa$group$Lg[1:5,1:5]), max.col.width ="7em")| data | |
|---|---|
| Materiel | 1.253 |
| Emploi | 1.241 |
| Satisfaction | 1.544 |
| Sante_Securite | 1.753 |
| Enseignement | 1.379 |
> print_table(ocde.mfa$group$RV, max.col.width ="7em")| Materiel | Emploi | Satisfaction | Sante_Securite | Enseignement | MFA | |
|---|---|---|---|---|---|---|
| Materiel | 1.000 | 0.485 | 0.290 | 0.513 | 0.124 | 0.654 |
| Emploi | 0.485 | 1.000 | 0.619 | 0.415 | 0.394 | 0.790 |
| Satisfaction | 0.290 | 0.619 | 1.000 | 0.504 | 0.500 | 0.807 |
| Sante_Securite | 0.513 | 0.415 | 0.504 | 1.000 | 0.256 | 0.756 |
| Enseignement | 0.124 | 0.394 | 0.500 | 0.256 | 1.000 | 0.624 |
| MFA | 0.654 | 0.790 | 0.807 | 0.756 | 0.624 | 1.000 |
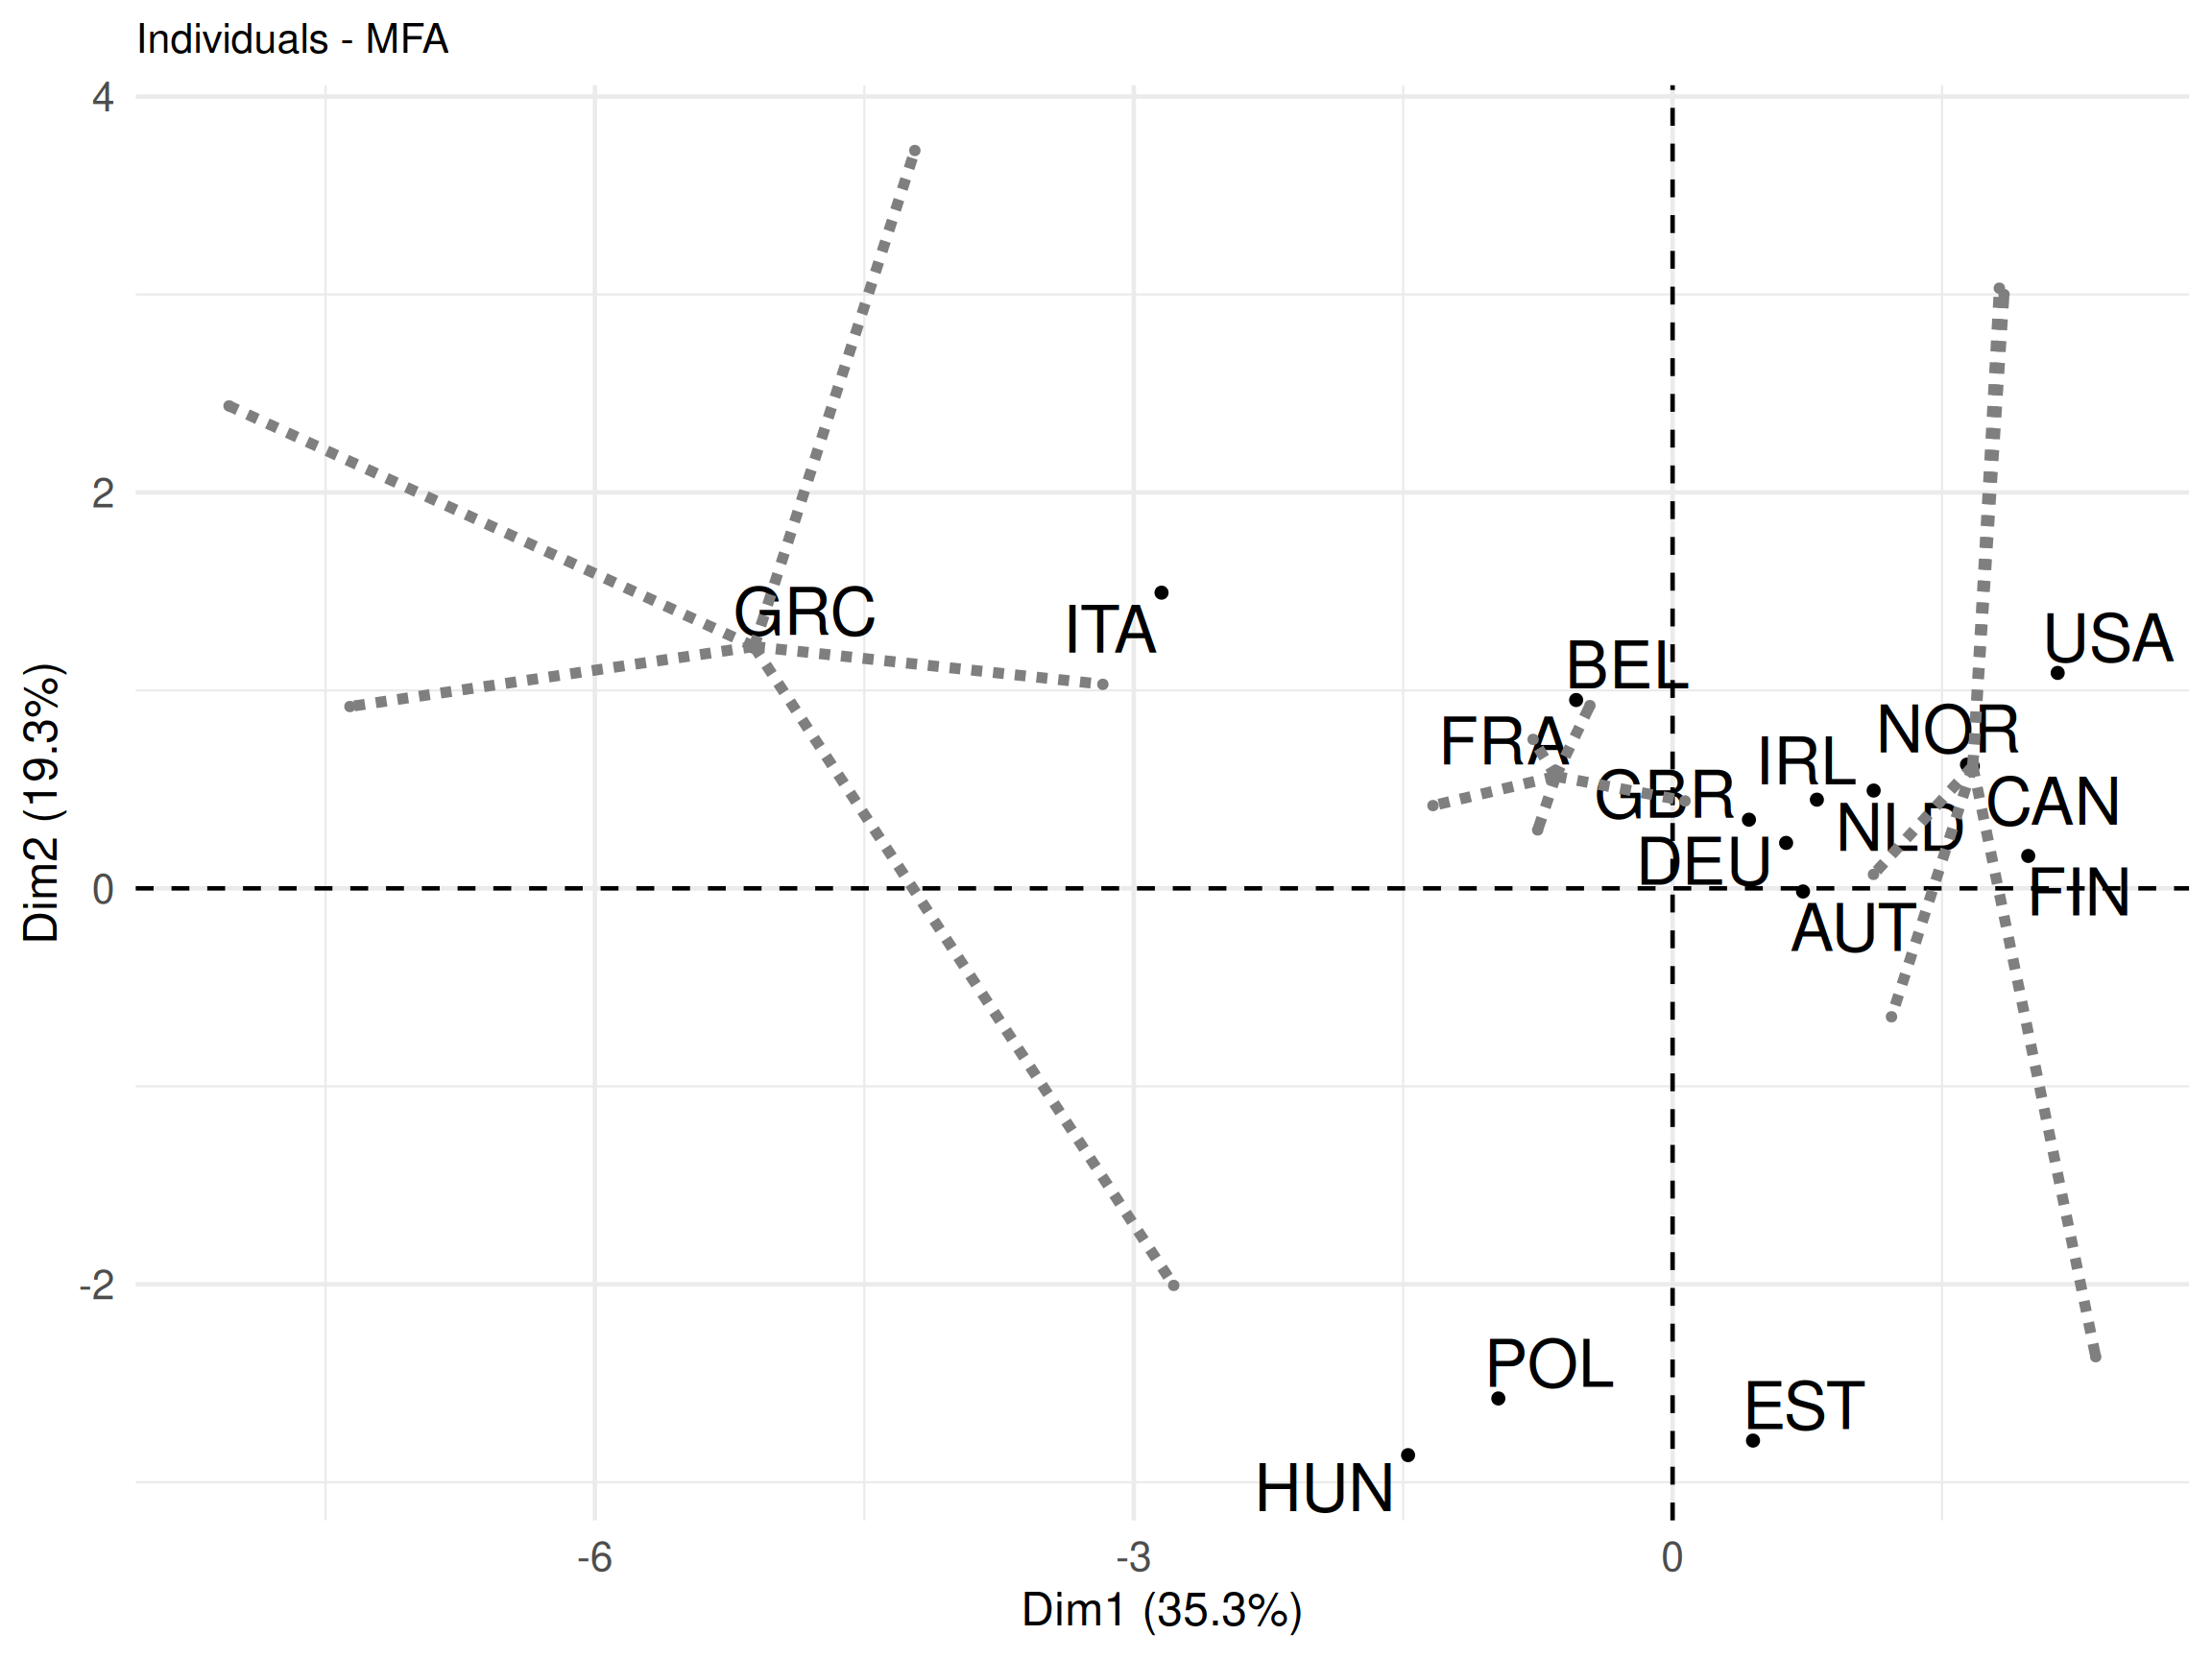
| Dim.1 | Dim.2 | Dim.3 | |
|---|---|---|---|
| CAN | 0.932 | 16.572 | 2.002 |
| FRA | 0.947 | 0.203 | 7.748 |
| GRC | 21.371 | 13.595 | 19.732 |
| Dim.1 | Dim.2 | Dim.3 | |
|---|---|---|---|
| CAN.Materiel | 0.020 | 4.331 | 0.343 |
| CAN.Emploi | 0.276 | 0.222 | 1.233 |
| CAN.Satisfaction | 0.185 | 1.191 | 0.154 |
| CAN.Sante_Securite | 0.027 | 4.216 | 0.088 |
| CAN.Enseignement | 0.423 | 6.612 | 0.184 |
| FRA.Materiel | 0.468 | 0.012 | 0.076 |
| FRA.Emploi | 0.033 | 0.095 | 2.170 |
| FRA.Satisfaction | 0.014 | 0.026 | 4.395 |
| FRA.Sante_Securite | 0.422 | 0.016 | 0.302 |
| FRA.Enseignement | 0.009 | 0.055 | 0.804 |
| GRC.Materiel | 4.935 | 7.738 | 6.845 |
| GRC.Emploi | 7.725 | 1.097 | 0.415 |
| GRC.Satisfaction | 4.578 | 0.068 | 7.240 |
| GRC.Sante_Securite | 3.409 | 0.027 | 1.482 |
| GRC.Enseignement | 0.724 | 4.665 | 3.750 |