> library(ca)
> data(smoke)
> print_table(smoke)| none | light | medium | heavy | |
|---|---|---|---|---|
| SM | 4 | 2 | 3 | 2 |
| JM | 4 | 3 | 7 | 4 |
| SE | 25 | 10 | 12 | 4 |
| JE | 18 | 24 | 33 | 13 |
| SC | 10 | 6 | 7 | 2 |
> sum(smoke)[1] 193Il s’agit d’un tableau de contingence croisant 5 catégories de salariés (en lignes) et 4 catégories de fumeurs (en colonnes) au sein d’une entreprise :
SM : Senior Managers; JM : Junior Managers; SE : Senior Employees; JE : Junior Employees; SC : Secretaries.> library(ca)
> data(smoke)
> print_table(smoke)| none | light | medium | heavy | |
|---|---|---|---|---|
| SM | 4 | 2 | 3 | 2 |
| JM | 4 | 3 | 7 | 4 |
| SE | 25 | 10 | 12 | 4 |
| JE | 18 | 24 | 33 | 13 |
| SC | 10 | 6 | 7 | 2 |
> sum(smoke)[1] 193> chisq.test(smoke, simulate.p.value=TRUE)
    Pearson's Chi-squared test with simulated p-value (based on 2000
    replicates)

data:  smoke
X-squared = 16.442, df = NA, p-value = 0.1709
Que conclut-on quant à la significativité statistique de l’association ? Quel garde-fou méthodologique faut-il garder en tête lors des questions suivantes ?
Préparation des données
?? dans les sorties ci-dessous :Le vecteur r des masses des lignes
[1] 0.06 ?? 0.26 0.46 0.13Le vecteur c des masses des colonnes
[1] 0.32 0.23 ?? 0.13La matrice Z des écarts à l’indépendance
| none | light | medium | heavy | |
|---|---|---|---|---|
| SM | 0.15 | -0.22 | -0.15 | 0.4 |
| JM | -0.3 | -0.29 | 0.21 | 0.72 |
| SE | ?? | -0.16 | -0.27 | -0.39 |
| JE | -0.35 | 0.17 | 0.17 | 0.14 |
| SC | 0.27 | 0.03 | -0.13 | -0.38 |
Représentation des données sur les axes factoriels
gsvd ci-dessous réalise la décomposition en valeurs singulières généralisée d’une matrice réelle Z de dimension n \times p avec les métriques diagonales N = \operatorname{Diag}(r) sur \mathbb{R}^n et M = \operatorname{Diag}(c) sur \mathbb{R}^p.> # Fonction SVD généralisée avec métriques diagonales
> gsvd <- function(Z, r, c) {
+ #-----Entrée---------------
+ # Z : matrice numérique de dimension (n, p) et de rang k
+ # r : poids de la métrique des lignes N = diag(r)
+ # c : poids de la métrique des colonnes M = diag(c)
+ #-----Sortie---------------
+ # d : vecteur de taille k contenant les valeurs singulières (racines carrées des valeurs propres)
+ # U : matrice de dimension (n, k) des vecteurs propres de ZMZ'N
+ # V : matrice de dimension (p, k) des vecteurs propres de Z'NZM
+ #----------------------------
+
+ k <- qr(Z)$rank
+ colnames_Z <- colnames(Z)
+ rownames_Z <- rownames(Z)
+ Z <- as.matrix(Z)
+
+ Ztilde <- diag(sqrt(r)) %*% Z %*% diag(sqrt(c))
+ e <- svd(Ztilde)
+
+ U <- diag(1 / sqrt(r)) %*% e$u[, 1:k]
+ V <- diag(1 / sqrt(c)) %*% e$v[, 1:k]
+ d <- e$d[1:k]
+
+ rownames(U) <- rownames_Z
+ rownames(V) <- colnames_Z
+ if (length(d) > 1) {
+ colnames(U) <- colnames(V) <- paste0("dim", 1:k)
+ }
+ return(list(U = U, V = V, d = d))
+ }gsvd, le vecteur \Lambda des valeurs singulières ainsi que les matrices X et Y des coordonnées factorielles.> print_table(Lambda)| data |
|---|
| 0.273 |
| 0.100 |
| 0.020 |
et les matrices X et Y des coordonnées factorielles des profils-lignes et profils-colonnes de l’AFC
> print_table(X)| dim1 | dim2 | dim3 | |
|---|---|---|---|
| SM | -0.066 | -0.194 | 0.071 |
| JM | 0.259 | -0.243 | -0.034 |
| SE | -0.381 | -0.011 | -0.005 |
| JE | 0.233 | 0.058 | 0.003 |
| SC | -0.201 | 0.079 | -0.008 |
> print_table(Y)| dim1 | dim2 | dim3 | |
|---|---|---|---|
| none | -0.393 | -0.030 | -0.001 |
| light | 0.099 | 0.141 | 0.022 |
| medium | 0.196 | 0.007 | -0.026 |
| heavy | 0.294 | -0.198 | 0.026 |
Calculez les inerties associées à chaque axe ainsi que le pourcentage d’inertie expliquée par le premier plan factoriel.
Représentez à la main (ou sous R) les profils-lignes et les profils-colonnes sur le premier plan factoriel de l’AFC.
Exploitation des sorties FactoMineR suivantes :
> library(FactoMineR)
>
> res <- CA(smoke, graph = FALSE)
>
> stopifnot(isTRUE(all.equal(abs(unname(res$row$coord)), abs(unname(X)), tolerance = 1e-8)))
> stopifnot(isTRUE(all.equal(abs(unname(res$col$coord)), abs(unname(Y)), tolerance = 1e-8)))
Expliquez le code R ci-dessus.
On donne :
> print_table(res$row$contrib)| Dim 1 | Dim 2 | Dim 3 | |
|---|---|---|---|
| SM | 0.330 | 21.356 | 69.433 |
| JM | 8.366 | 55.115 | 25.619 |
| SE | 51.201 | 0.300 | 1.698 |
| JE | 33.097 | 15.177 | 1.205 |
| SC | 7.006 | 8.052 | 2.045 |
> print_table(res$col$contrib)| Dim 1 | Dim 2 | Dim 3 | |
|---|---|---|---|
| none | 65.400 | 2.934 | 0.061 |
| light | 3.085 | 46.317 | 27.282 |
| medium | 16.562 | 0.174 | 51.140 |
| heavy | 14.954 | 50.575 | 21.517 |
Pourquoi ne prend-on pas la peine d’afficher res$row$cos2 et res$col$cos2 ?
On considère un jeu de données référençant 1\,044 passagers du Titanic, décrivant les variables suivantes :
Survived : Survie du passager (0 = \text{Non}, 1 = \text{Oui})Pclass : Classe du billet (1^{\text{ère}}, 2^{\text{ème}} ou 3^{\text{ème}})Sex : Sexe du passagerAge : Tranche d’âge (\left[0\,; 10\right], \left[11\,; 18\right], \left[19\,; 29\right], \left[30\,; 49\right], \ge 50)Fare : Prix du ticket (variable quantitative supplémentaire)Embarked : Port d’embarquement (\text{C} = \text{Cherbourg}, \text{Q} = \text{Queenstown}, \text{S} = \text{Southampton})| eigenvalue | percentage of variance | cumulative percentage of variance | |
|---|---|---|---|
| dim 1 | 0.382 | 19.116 | 19.116 |
| dim 2 | 0.272 | 13.589 | 32.705 |
| dim 3 | 0.234 | 11.707 | 44.412 |
| dim 4 | 0.201 | 10.051 | 54.463 |
| dim 5 | 0.200 | 9.989 | 64.452 |
| dim 6 | 0.194 | 9.682 | 74.134 |
| dim 7 | 0.190 | 9.518 | 83.651 |
| dim 8 | 0.150 | 7.493 | 91.144 |
| dim 9 | 0.098 | 4.913 | 96.057 |
| dim 10 | 0.079 | 3.943 | 100.000 |
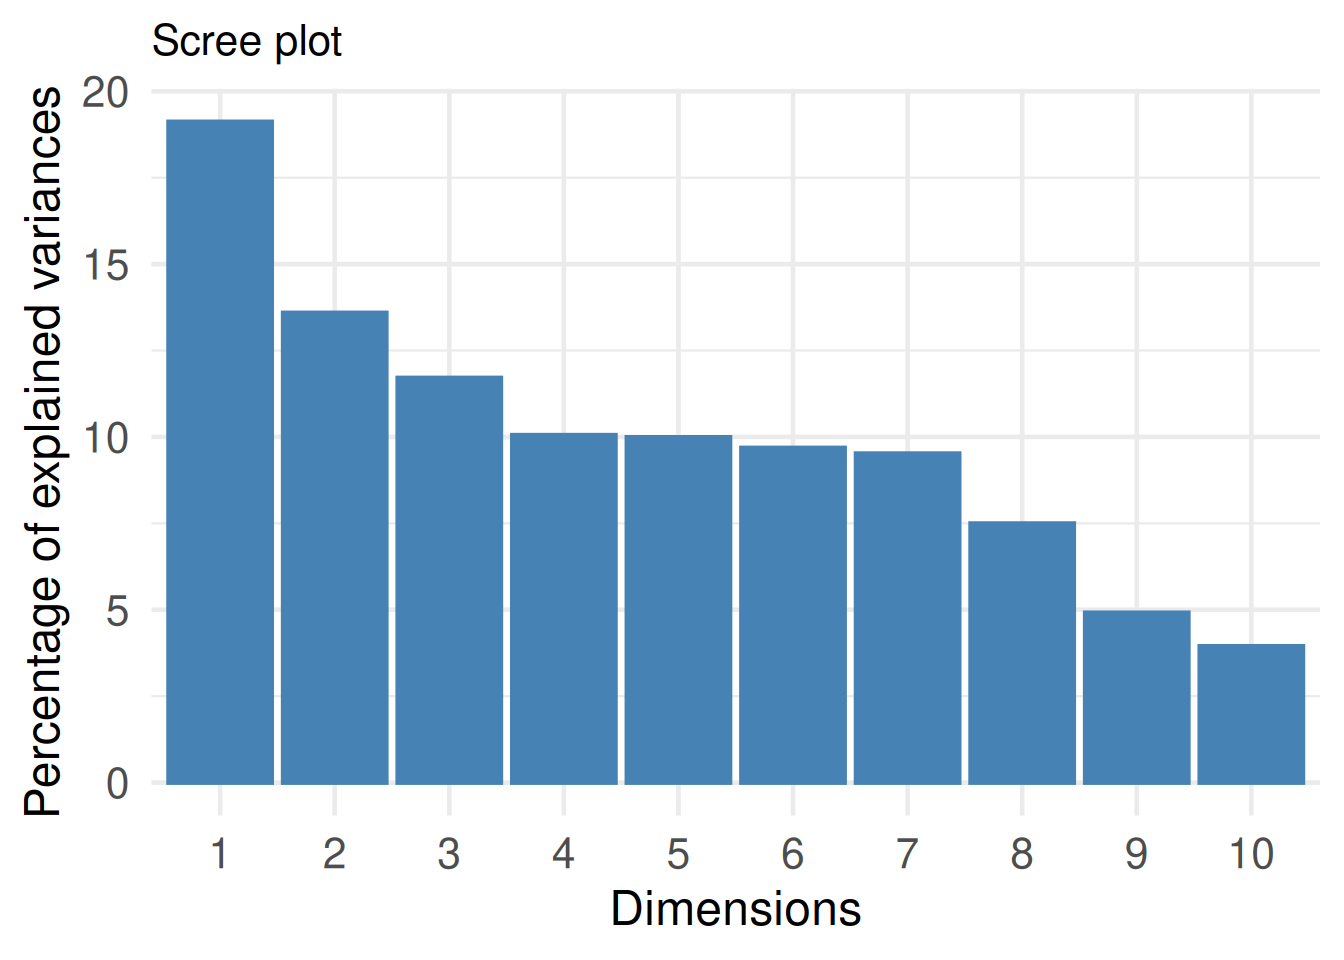
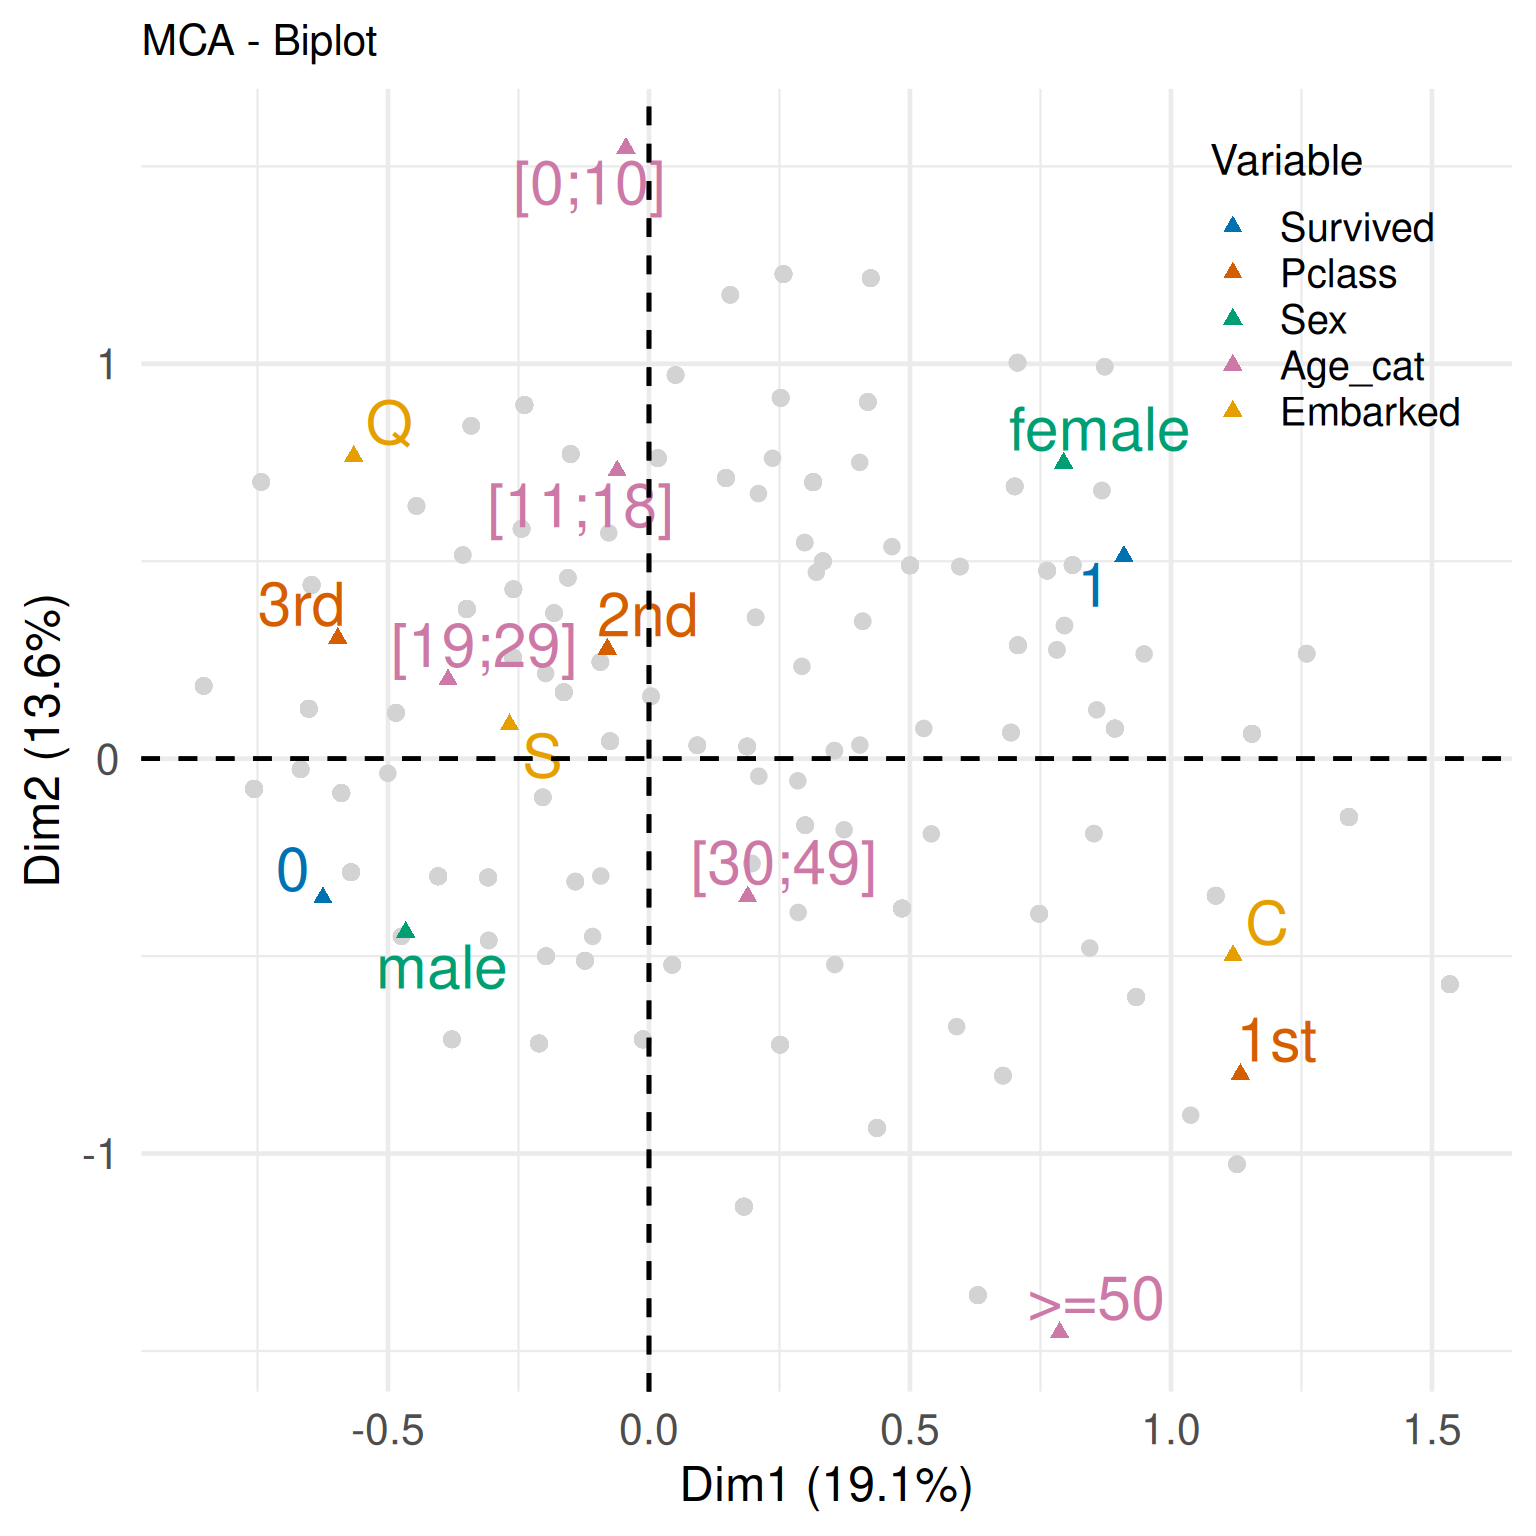
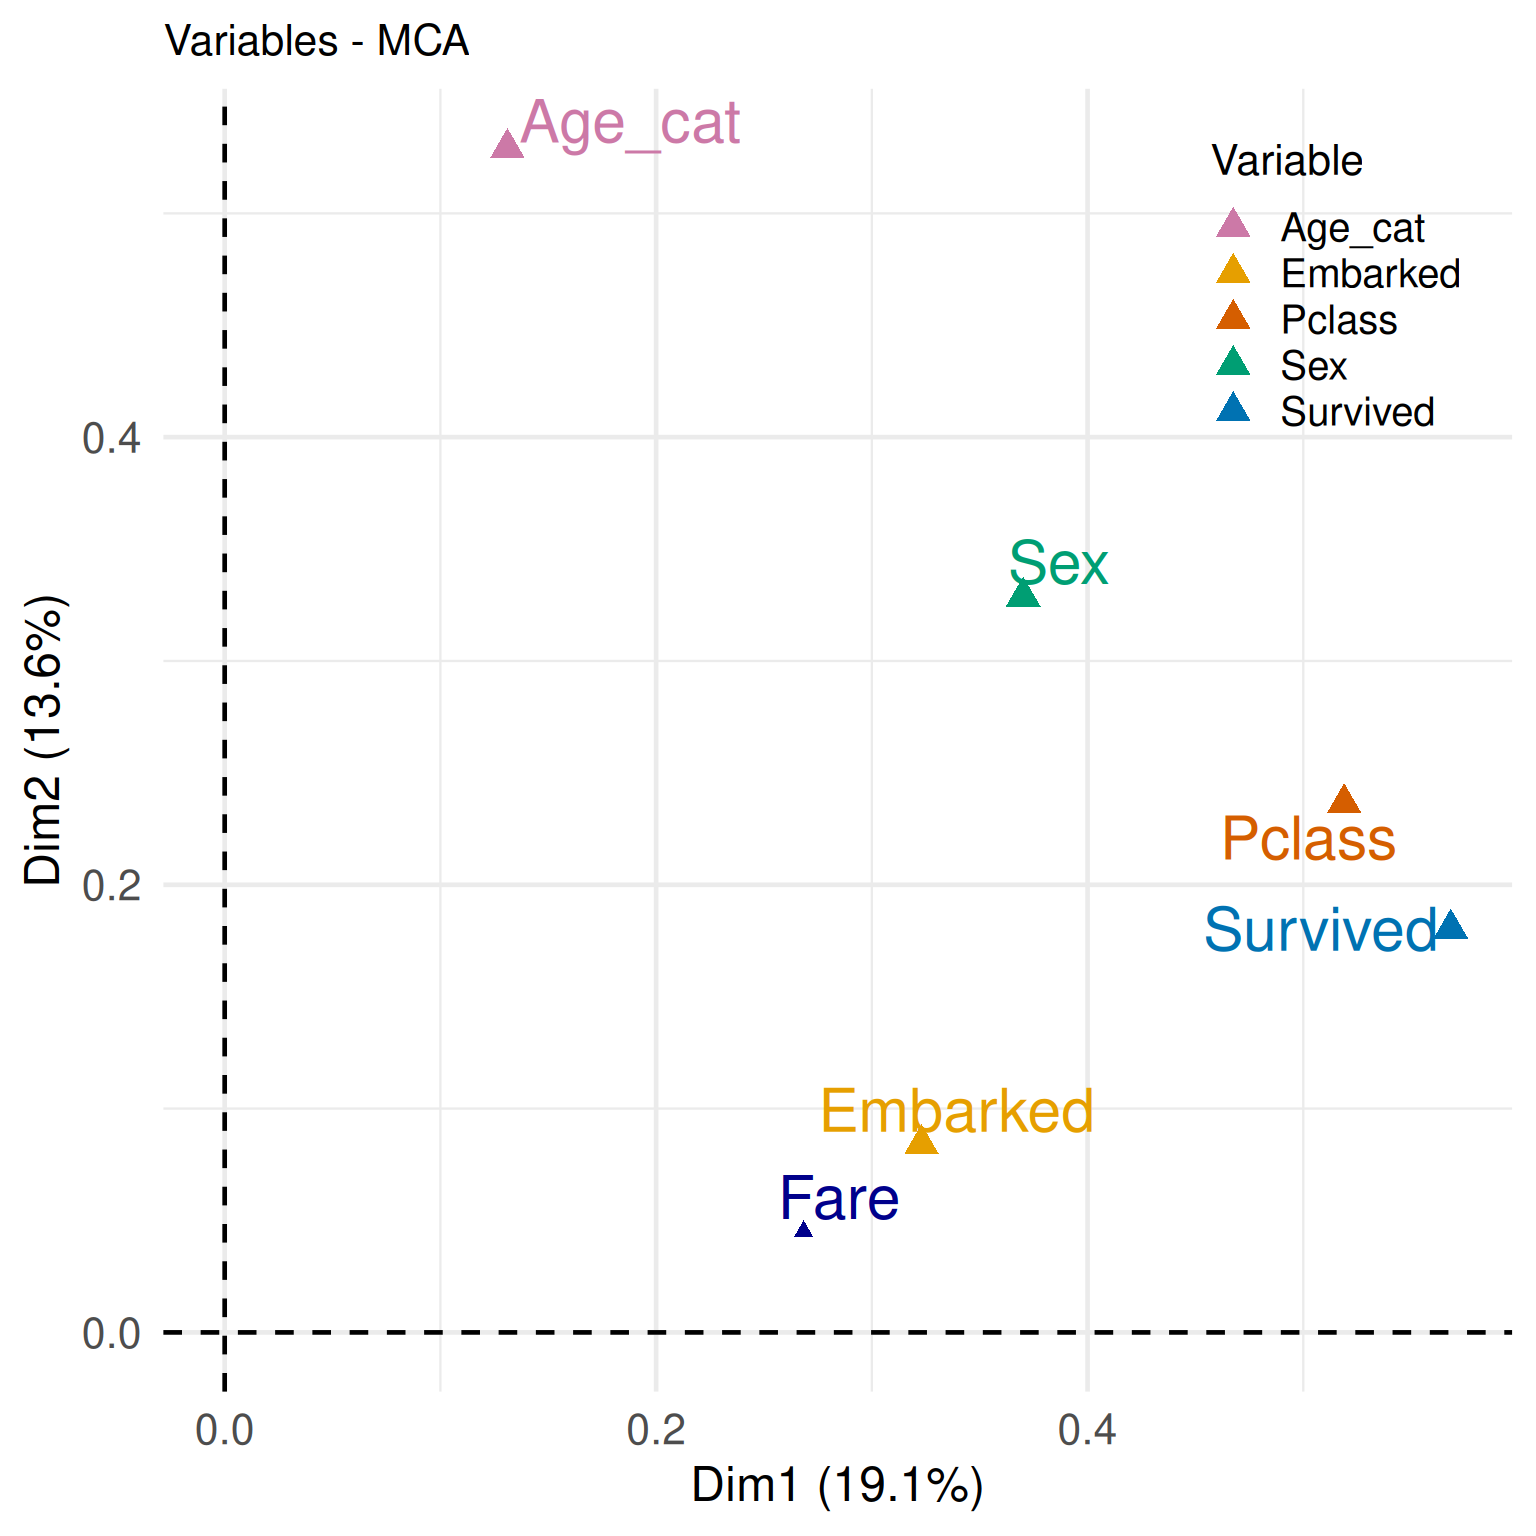
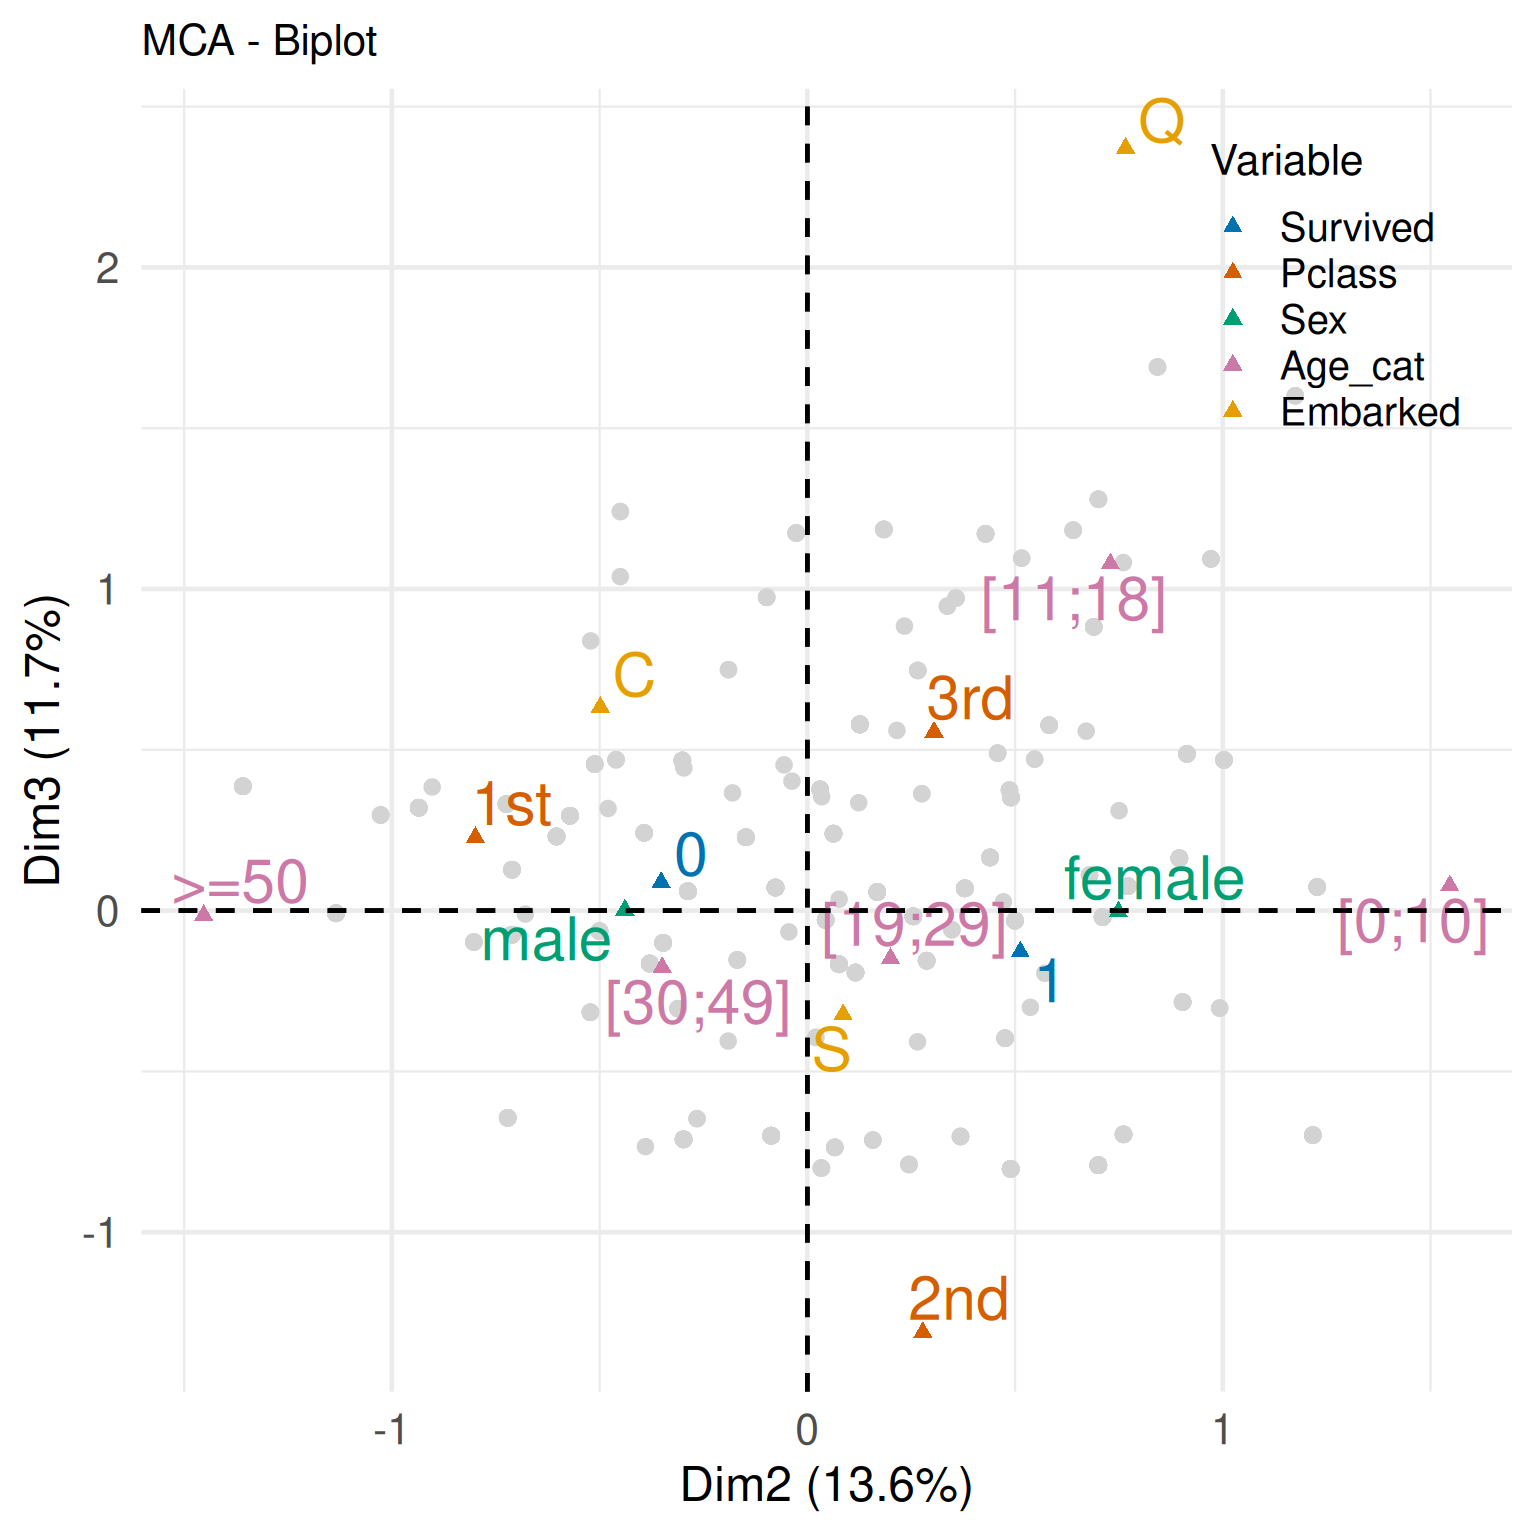
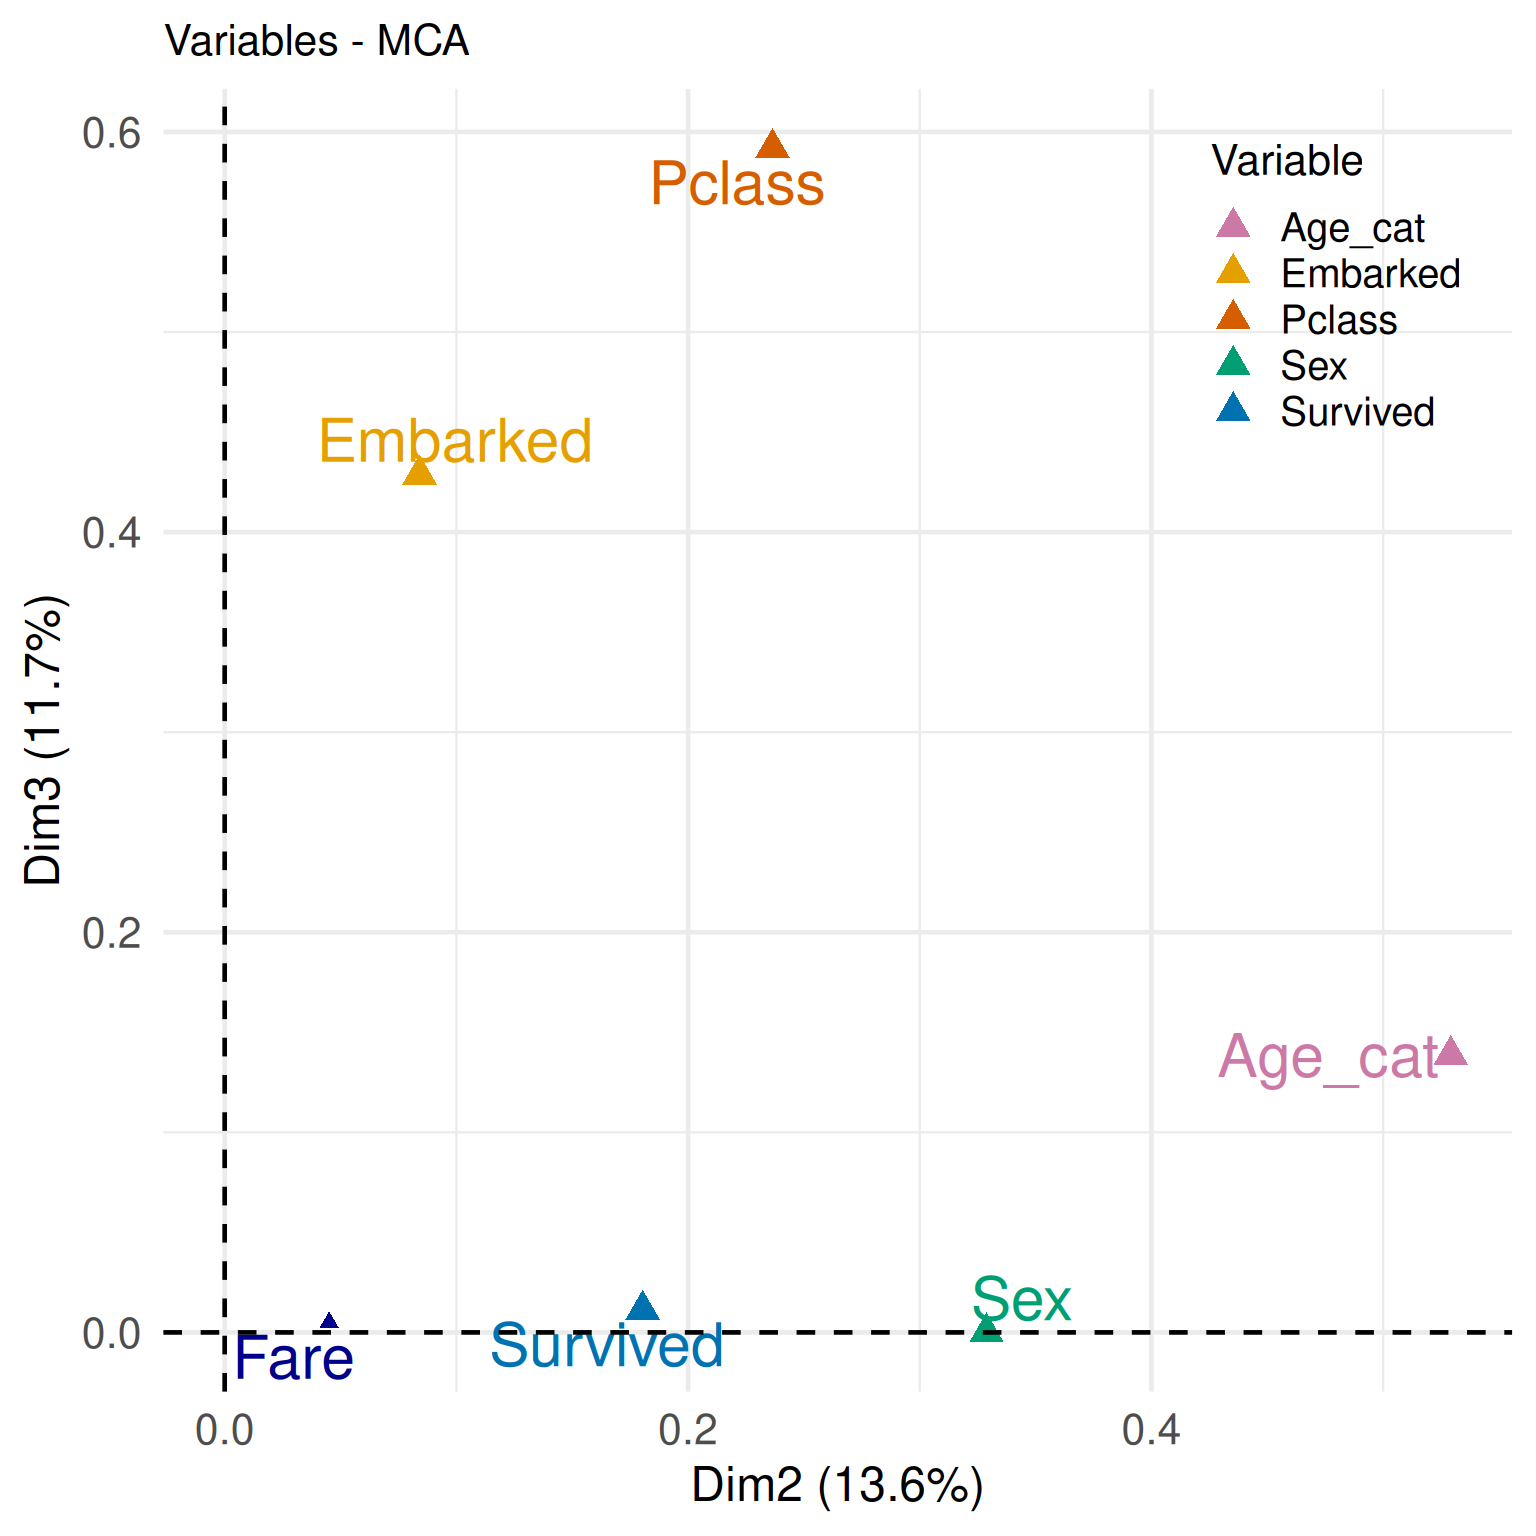
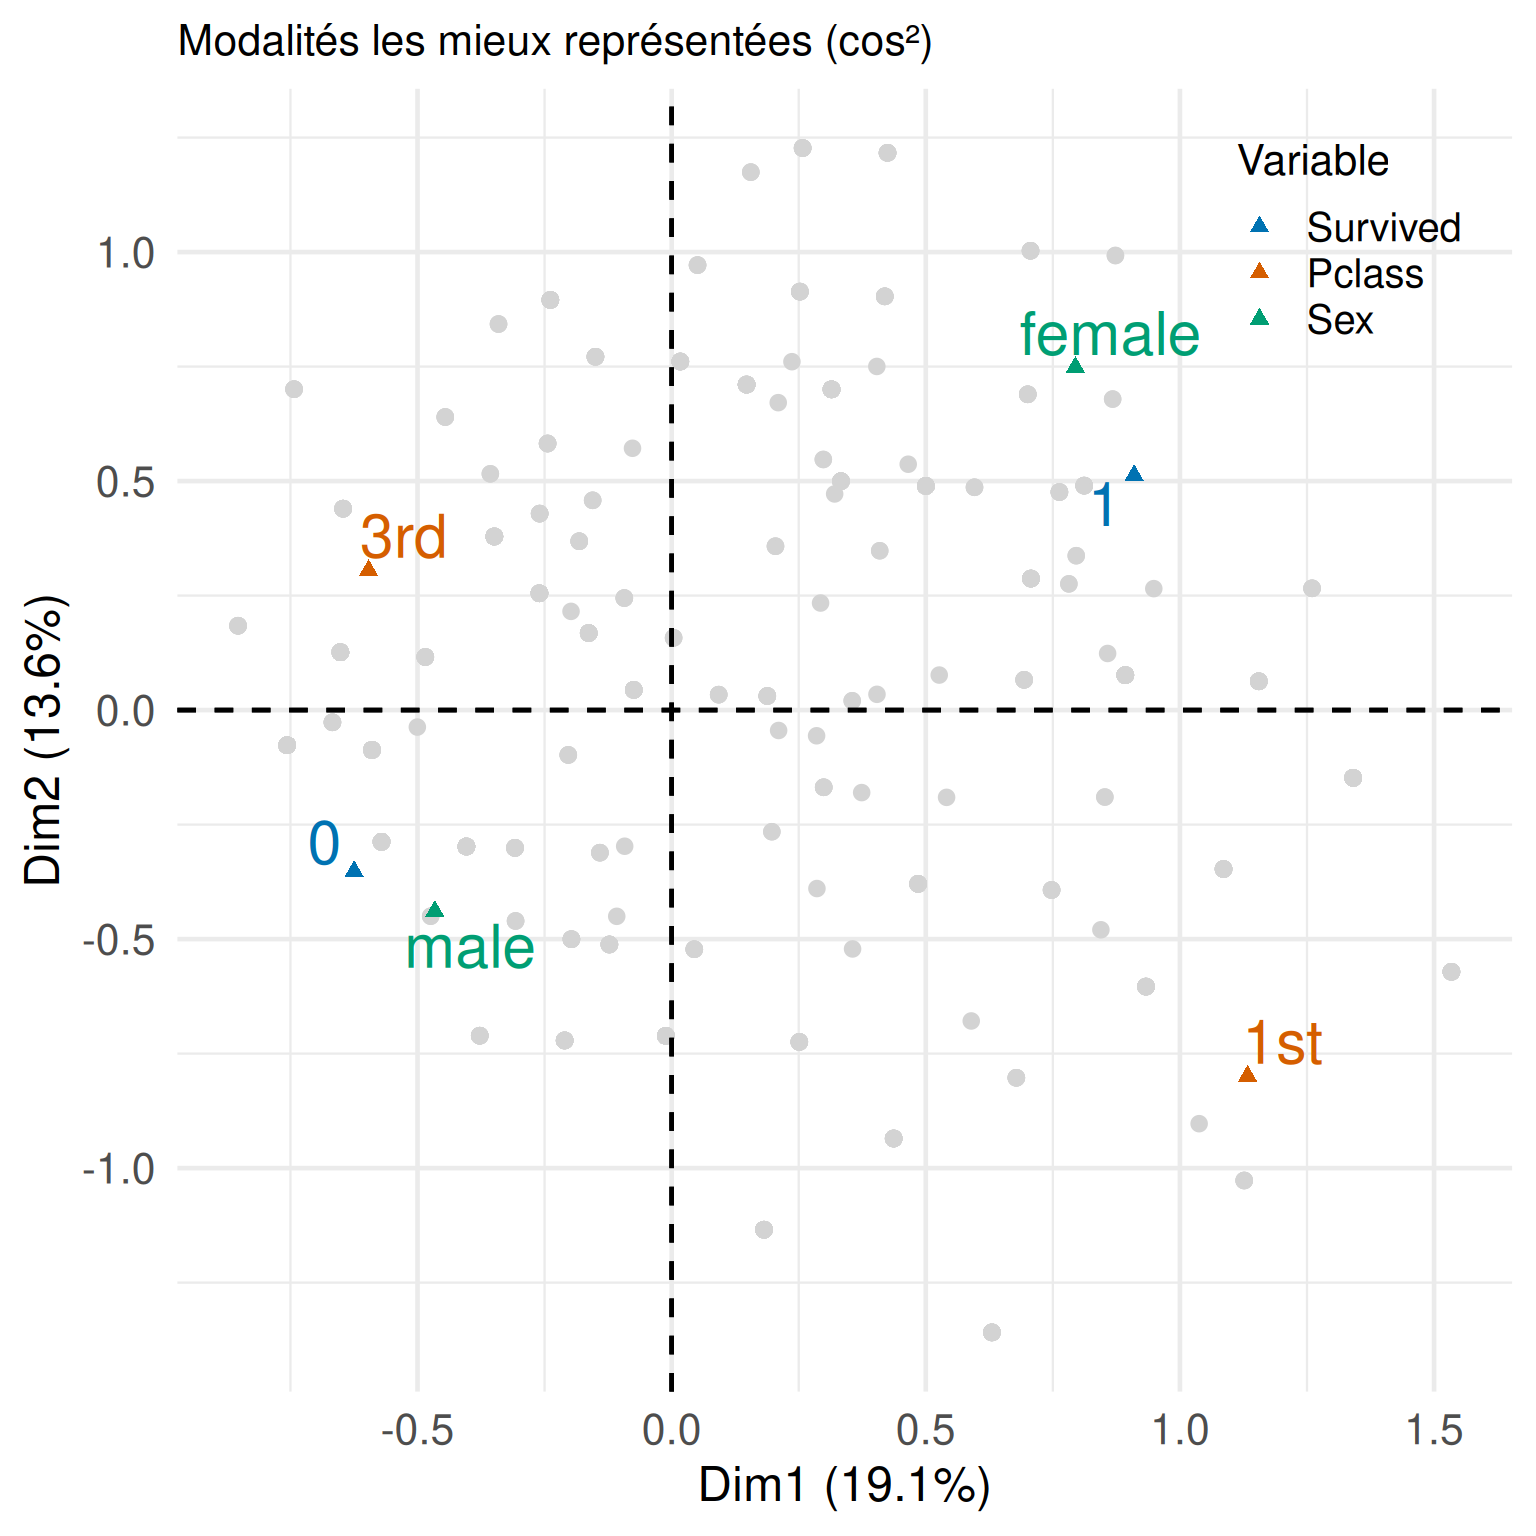
Survived.> print_table(
+ titanic.mca$var$contrib[,1:3]
+ )| Dim 1 | Dim 2 | Dim 3 | |
|---|---|---|---|
| 0 | 12.104 | 5.404 | 0.393 |
| 1 | 17.629 | 7.871 | 0.572 |
| 1st | 18.141 | 12.693 | 1.193 |
| 2nd | 0.083 | 1.421 | 36.734 |
| 3rd | 8.924 | 3.285 | 12.638 |
| female | 12.205 | 15.250 | 0.000 |
| male | 7.159 | 8.946 | 0.000 |
| [0;10] | 0.008 | 14.495 | 0.042 |
| [11;18] | 0.020 | 4.011 | 10.186 |
| [19;29] | 2.791 | 1.062 | 0.683 |
| [30;49] | 0.657 | 3.151 | 0.929 |
| >=50 | 3.381 | 16.221 | 0.002 |
| C | 13.300 | 3.712 | 6.943 |
| Q | 0.802 | 2.068 | 23.003 |
| S | 2.797 | 0.409 | 6.681 |
> print_table(
+     titanic.mca$var$cos2[,1:3]
+ )| Dim 1 | Dim 2 | Dim 3 | |
|---|---|---|---|
| 0 | 0.568 | 0.180 | 0.011 |
| 1 | 0.568 | 0.180 | 0.011 |
| 1st | 0.475 | 0.236 | 0.019 |
| 2nd | 0.002 | 0.026 | 0.573 |
| 3rd | 0.328 | 0.086 | 0.284 |
| female | 0.370 | 0.329 | 0.000 |
| male | 0.370 | 0.329 | 0.000 |
| [0;10] | 0.000 | 0.215 | 0.001 |
| [11;18] | 0.000 | 0.061 | 0.133 |
| [19;29] | 0.083 | 0.023 | 0.012 |
| [30;49] | 0.019 | 0.066 | 0.017 |
| >=50 | 0.072 | 0.246 | 0.000 |
| C | 0.319 | 0.063 | 0.102 |
| Q | 0.016 | 0.030 | 0.283 |
| S | 0.213 | 0.022 | 0.312 |
Quelle tendance semble se dégager ?