| 100m | Long.jump | Shot.put | High.jump | 400m | 110m.hurdle | Discus | Pole.vault | Javeline | 1500m | Rank | Points | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| SEBRLE | 11.04 | 7.58 | 14.83 | 2.07 | 49.81 | 14.69 | 43.75 | 5.02 | 63.19 | 291.7 | 1 | 8217 |
| CLAY | 10.76 | 7.40 | 14.26 | 1.86 | 49.37 | 14.05 | 50.72 | 4.92 | 60.15 | 301.5 | 2 | 8122 |
| KARPOV | 11.02 | 7.30 | 14.77 | 2.04 | 48.37 | 14.09 | 48.95 | 4.92 | 50.31 | 300.2 | 3 | 8099 |
| BERNARD | 11.02 | 7.23 | 14.25 | 1.92 | 48.93 | 14.99 | 40.87 | 5.32 | 62.77 | 280.1 | 4 | 8067 |
| YURKOV | 11.34 | 7.09 | 15.19 | 2.10 | 50.42 | 15.31 | 46.26 | 4.72 | 63.44 | 276.4 | 5 | 8036 |
| WARNERS | 11.11 | 7.60 | 14.31 | 1.98 | 48.68 | 14.23 | 41.10 | 4.92 | 51.77 | 278.1 | 6 | 8030 |
| ZSIVOCZKY | 11.13 | 7.30 | 13.48 | 2.01 | 48.62 | 14.17 | 45.67 | 4.42 | 55.37 | 268.0 | 7 | 8004 |
| McMULLEN | 10.83 | 7.31 | 13.76 | 2.13 | 49.91 | 14.38 | 44.41 | 4.42 | 56.37 | 285.1 | 8 | 7995 |
| MARTINEAU | 11.64 | 6.81 | 14.57 | 1.95 | 50.14 | 14.93 | 47.60 | 4.92 | 52.33 | 262.1 | 9 | 7802 |
| HERNU | 11.37 | 7.56 | 14.41 | 1.86 | 51.10 | 15.06 | 44.99 | 4.82 | 57.19 | 285.1 | 10 | 7733 |
| BARRAS | 11.33 | 6.97 | 14.09 | 1.95 | 49.48 | 14.48 | 42.10 | 4.72 | 55.40 | 282.0 | 11 | 7708 |
| NOOL | 11.33 | 7.27 | 12.68 | 1.98 | 49.20 | 15.29 | 37.92 | 4.62 | 57.44 | 266.6 | 12 | 7651 |
| BOURGUIGNON | 11.36 | 6.80 | 13.46 | 1.86 | 51.16 | 15.67 | 40.49 | 5.02 | 54.68 | 291.7 | 13 | 7313 |
TD 4 – Classification Ascendante Hiérarchique & K-means
1 Exercice 1.
On reprend le jeu de données du Décastar :
Pourquoi une CAH est-elle préférable à l’algorithme des K-means dans ce contexte ?
On effectue d’abord une CAH à l’aide de la fonction
HCPCsur les 10 épreuves (centrées-réduites), en utilisant la distance euclidienne, puis on trace le dendrogramme associé.
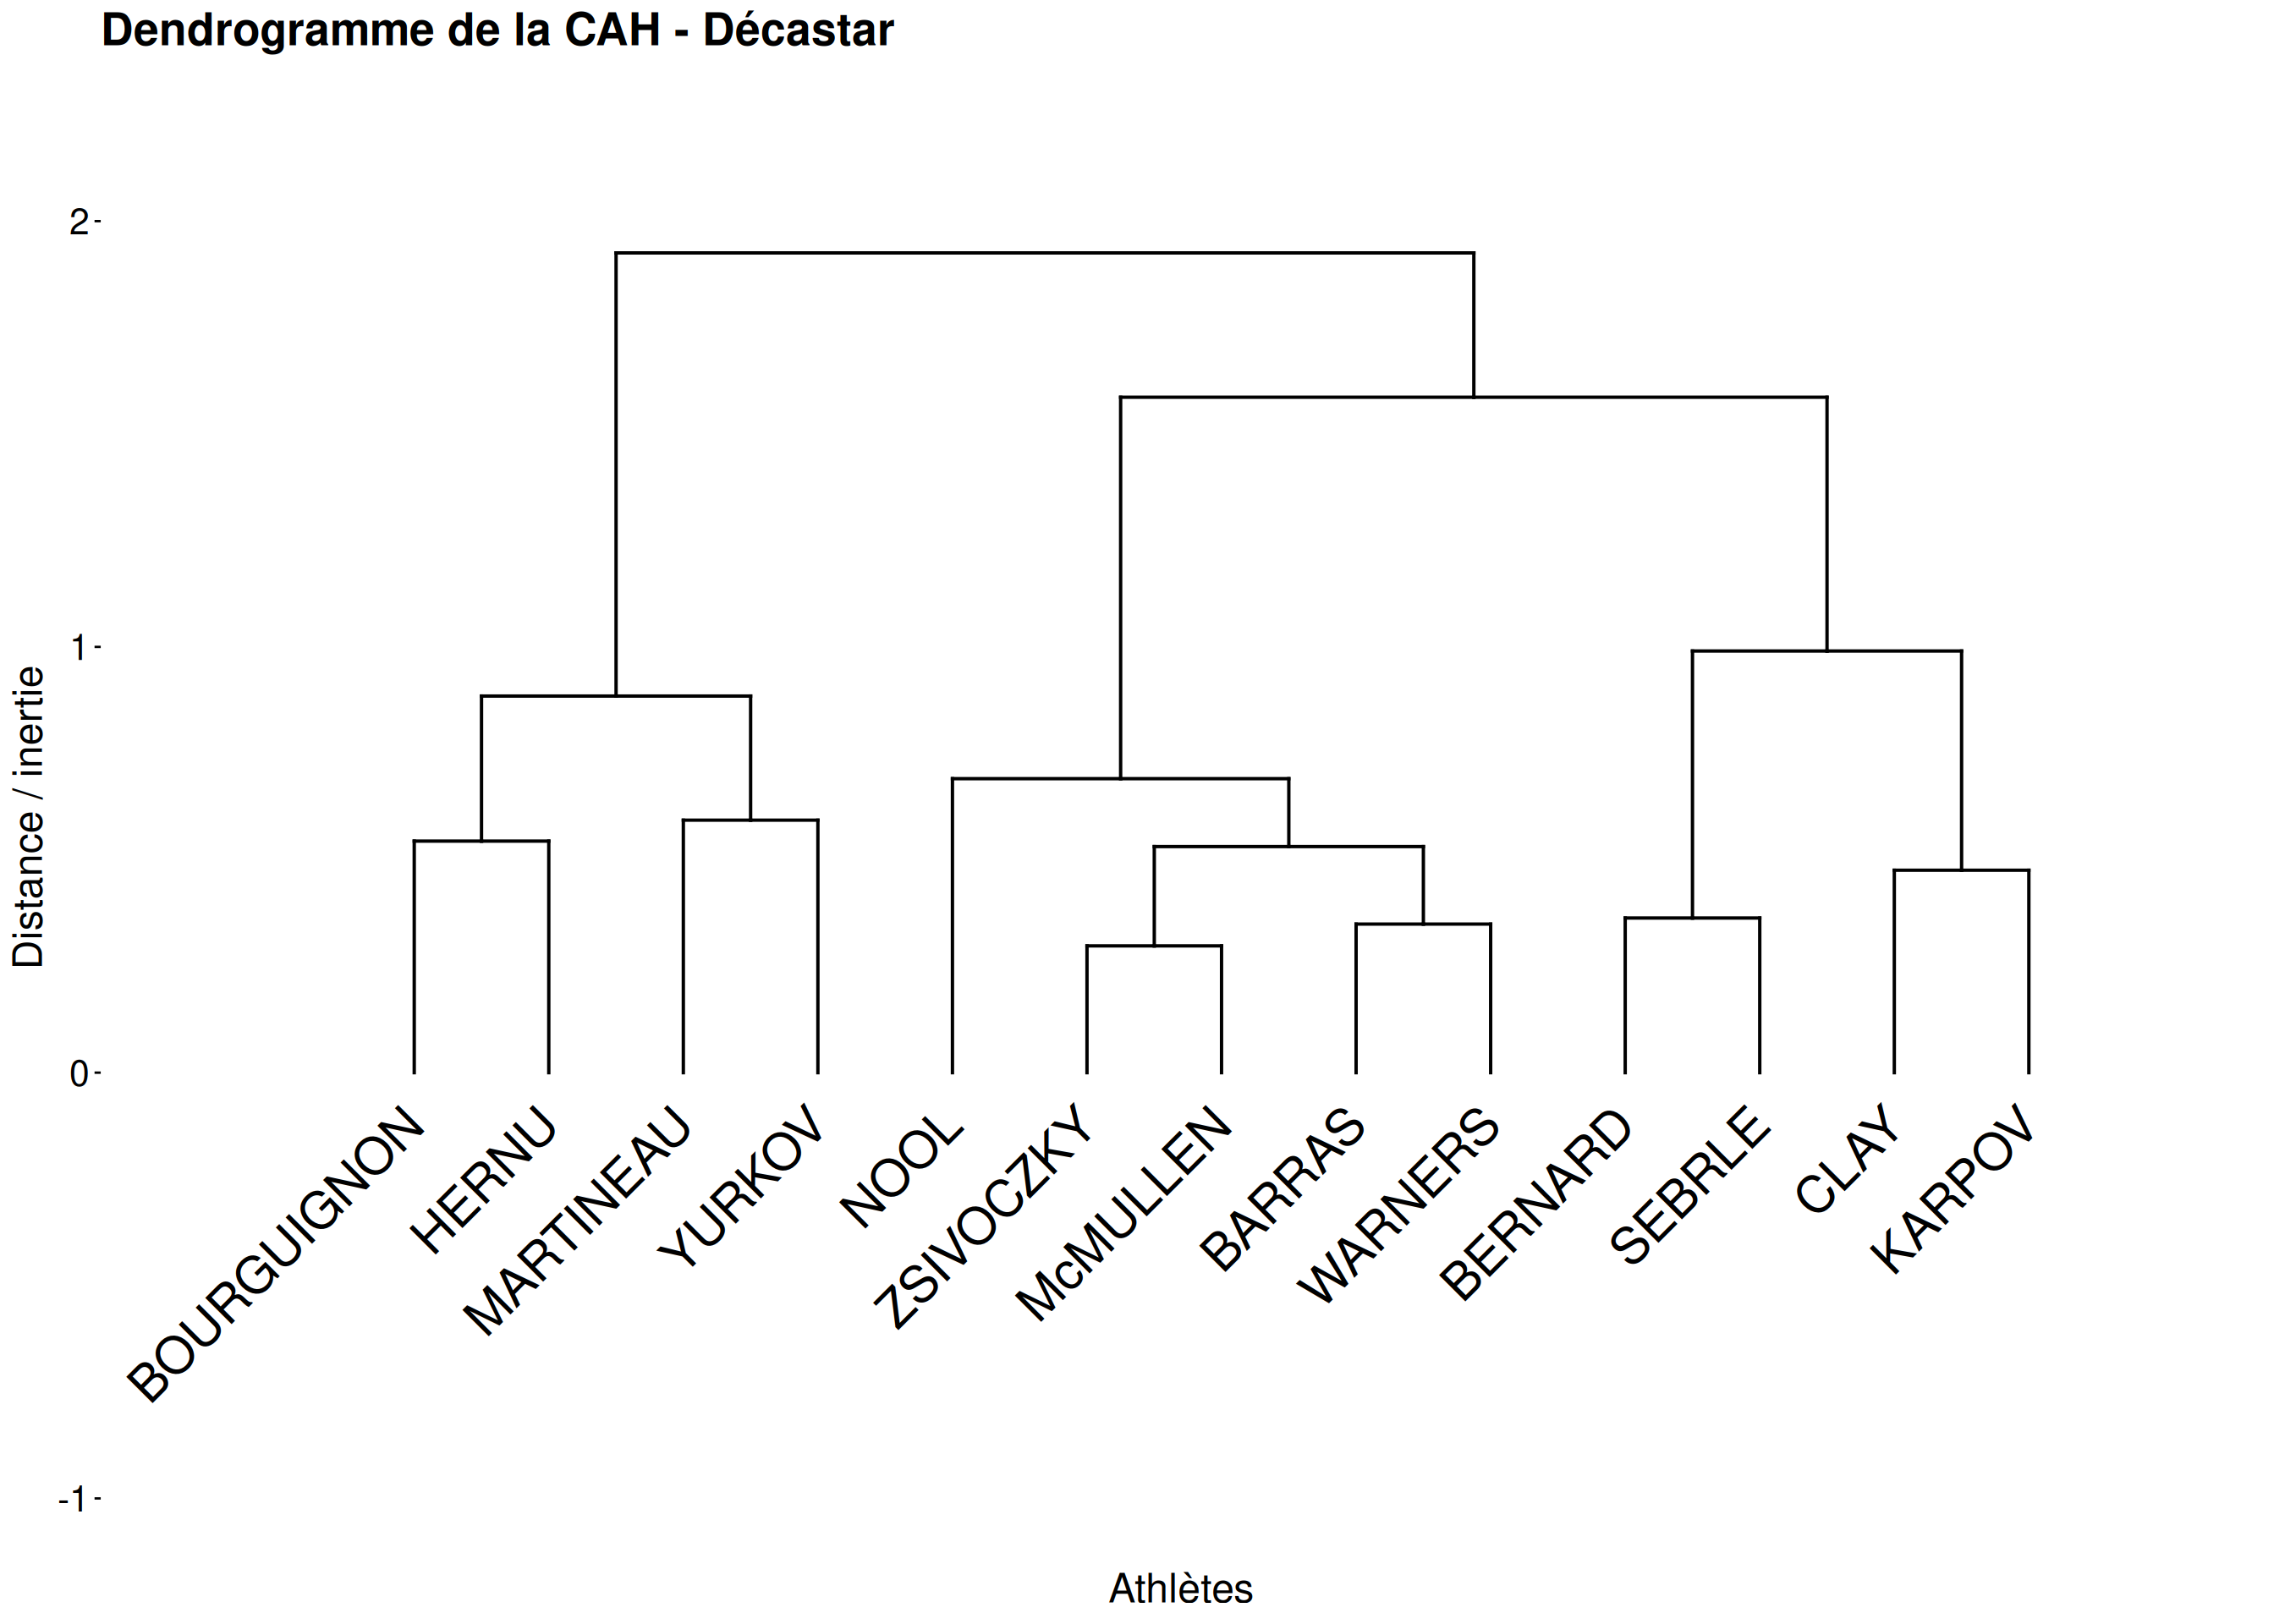
Que représente l’axe des ordonnées sur cette représentation graphique ? En vous appuyant uniquement sur le dendrogramme, combien de classes paraît-il naturel de conserver ?
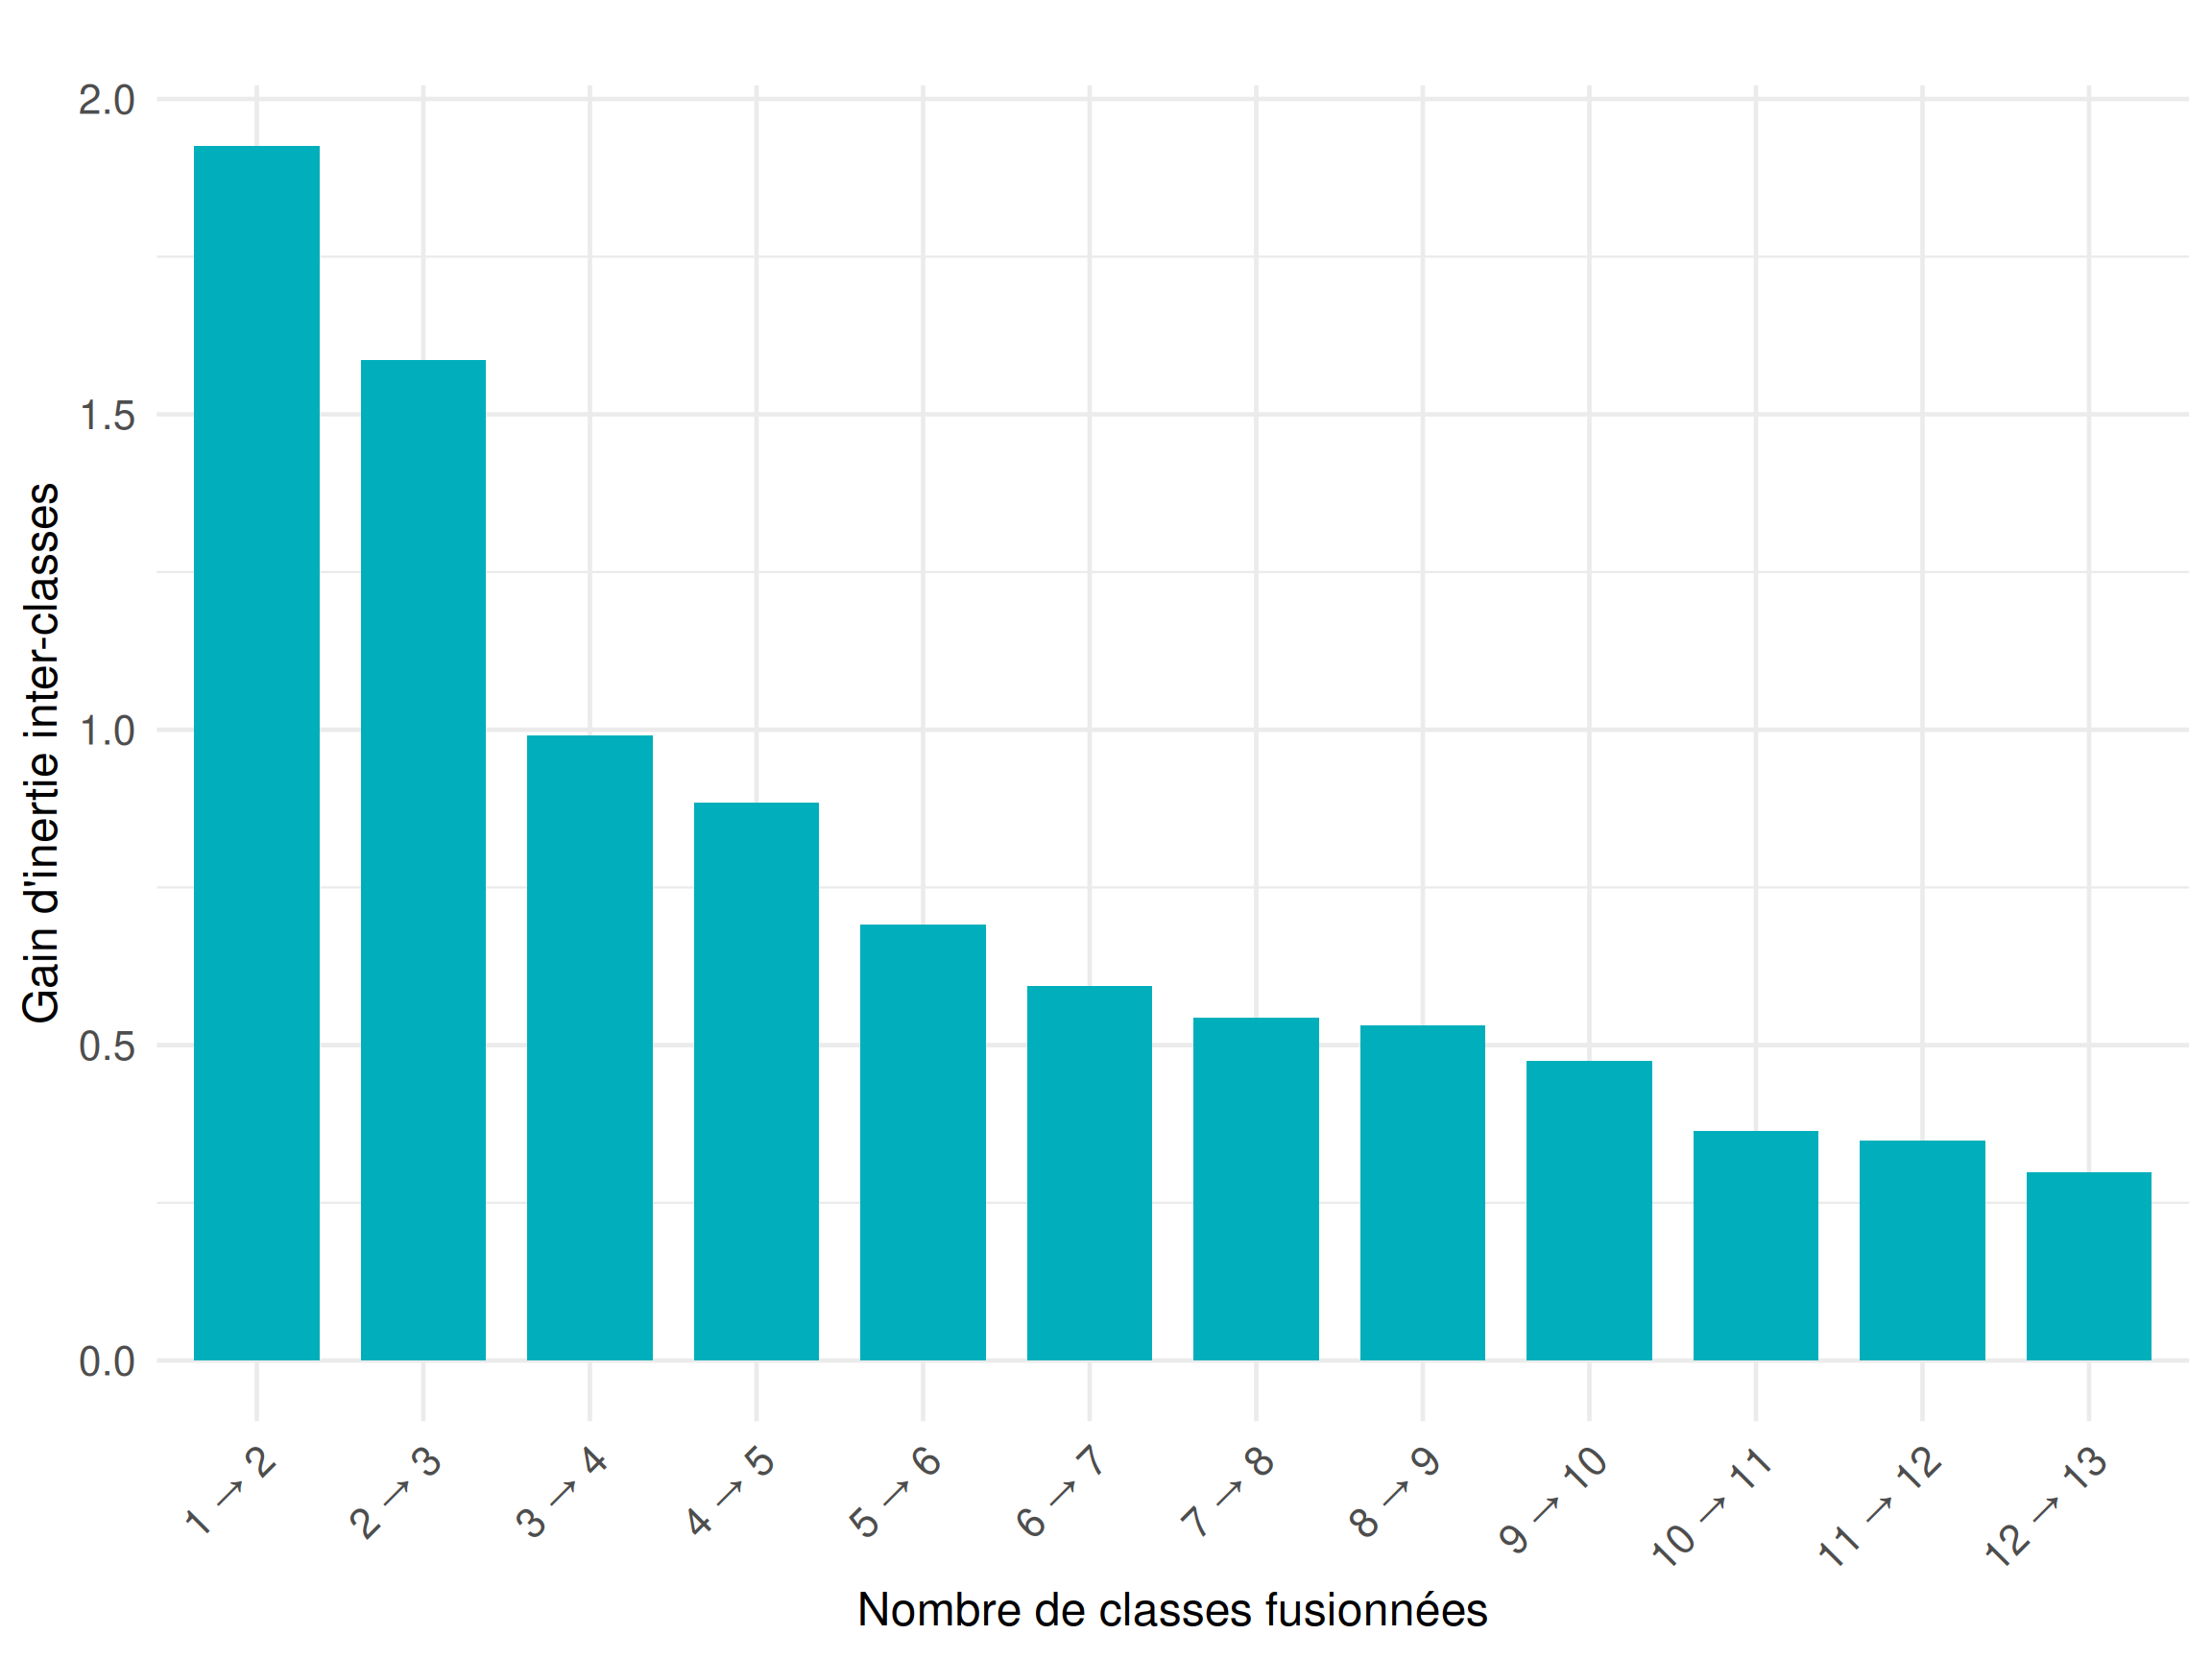
- Que représente concrètement ce graphique ? En vous appuyant sur cette représentation, combien de classes paraît-il opportun de retenir ?
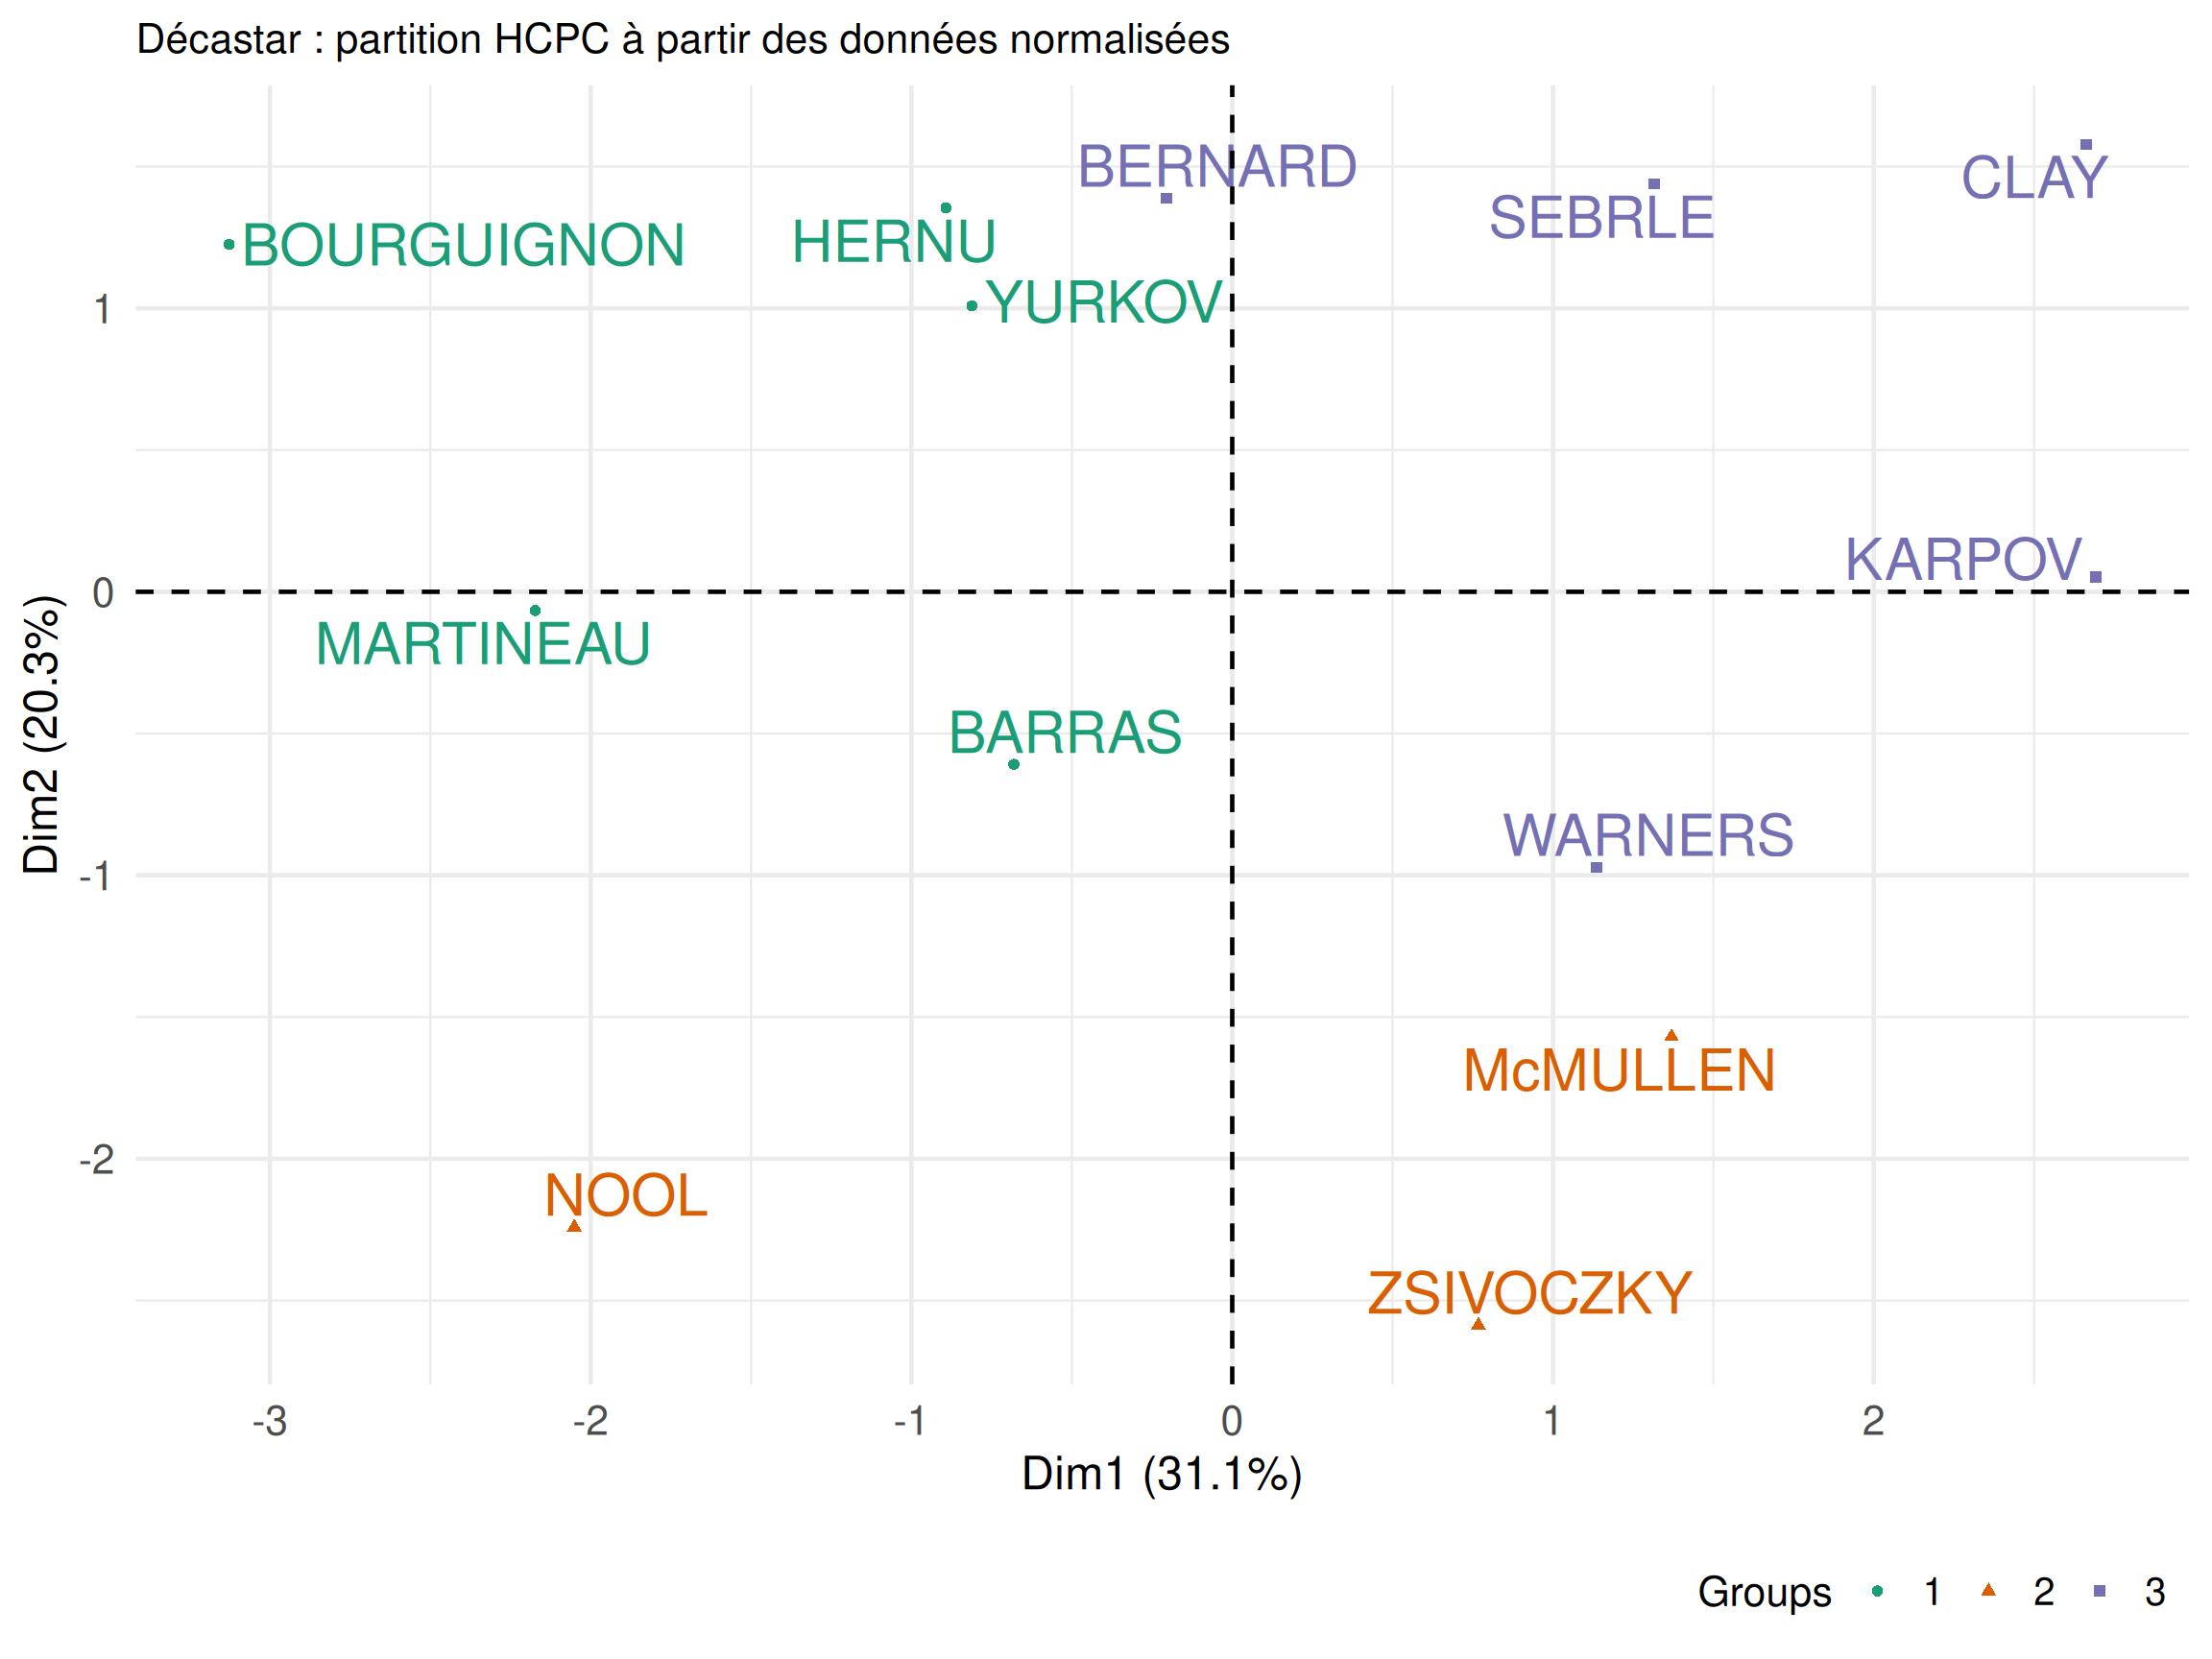
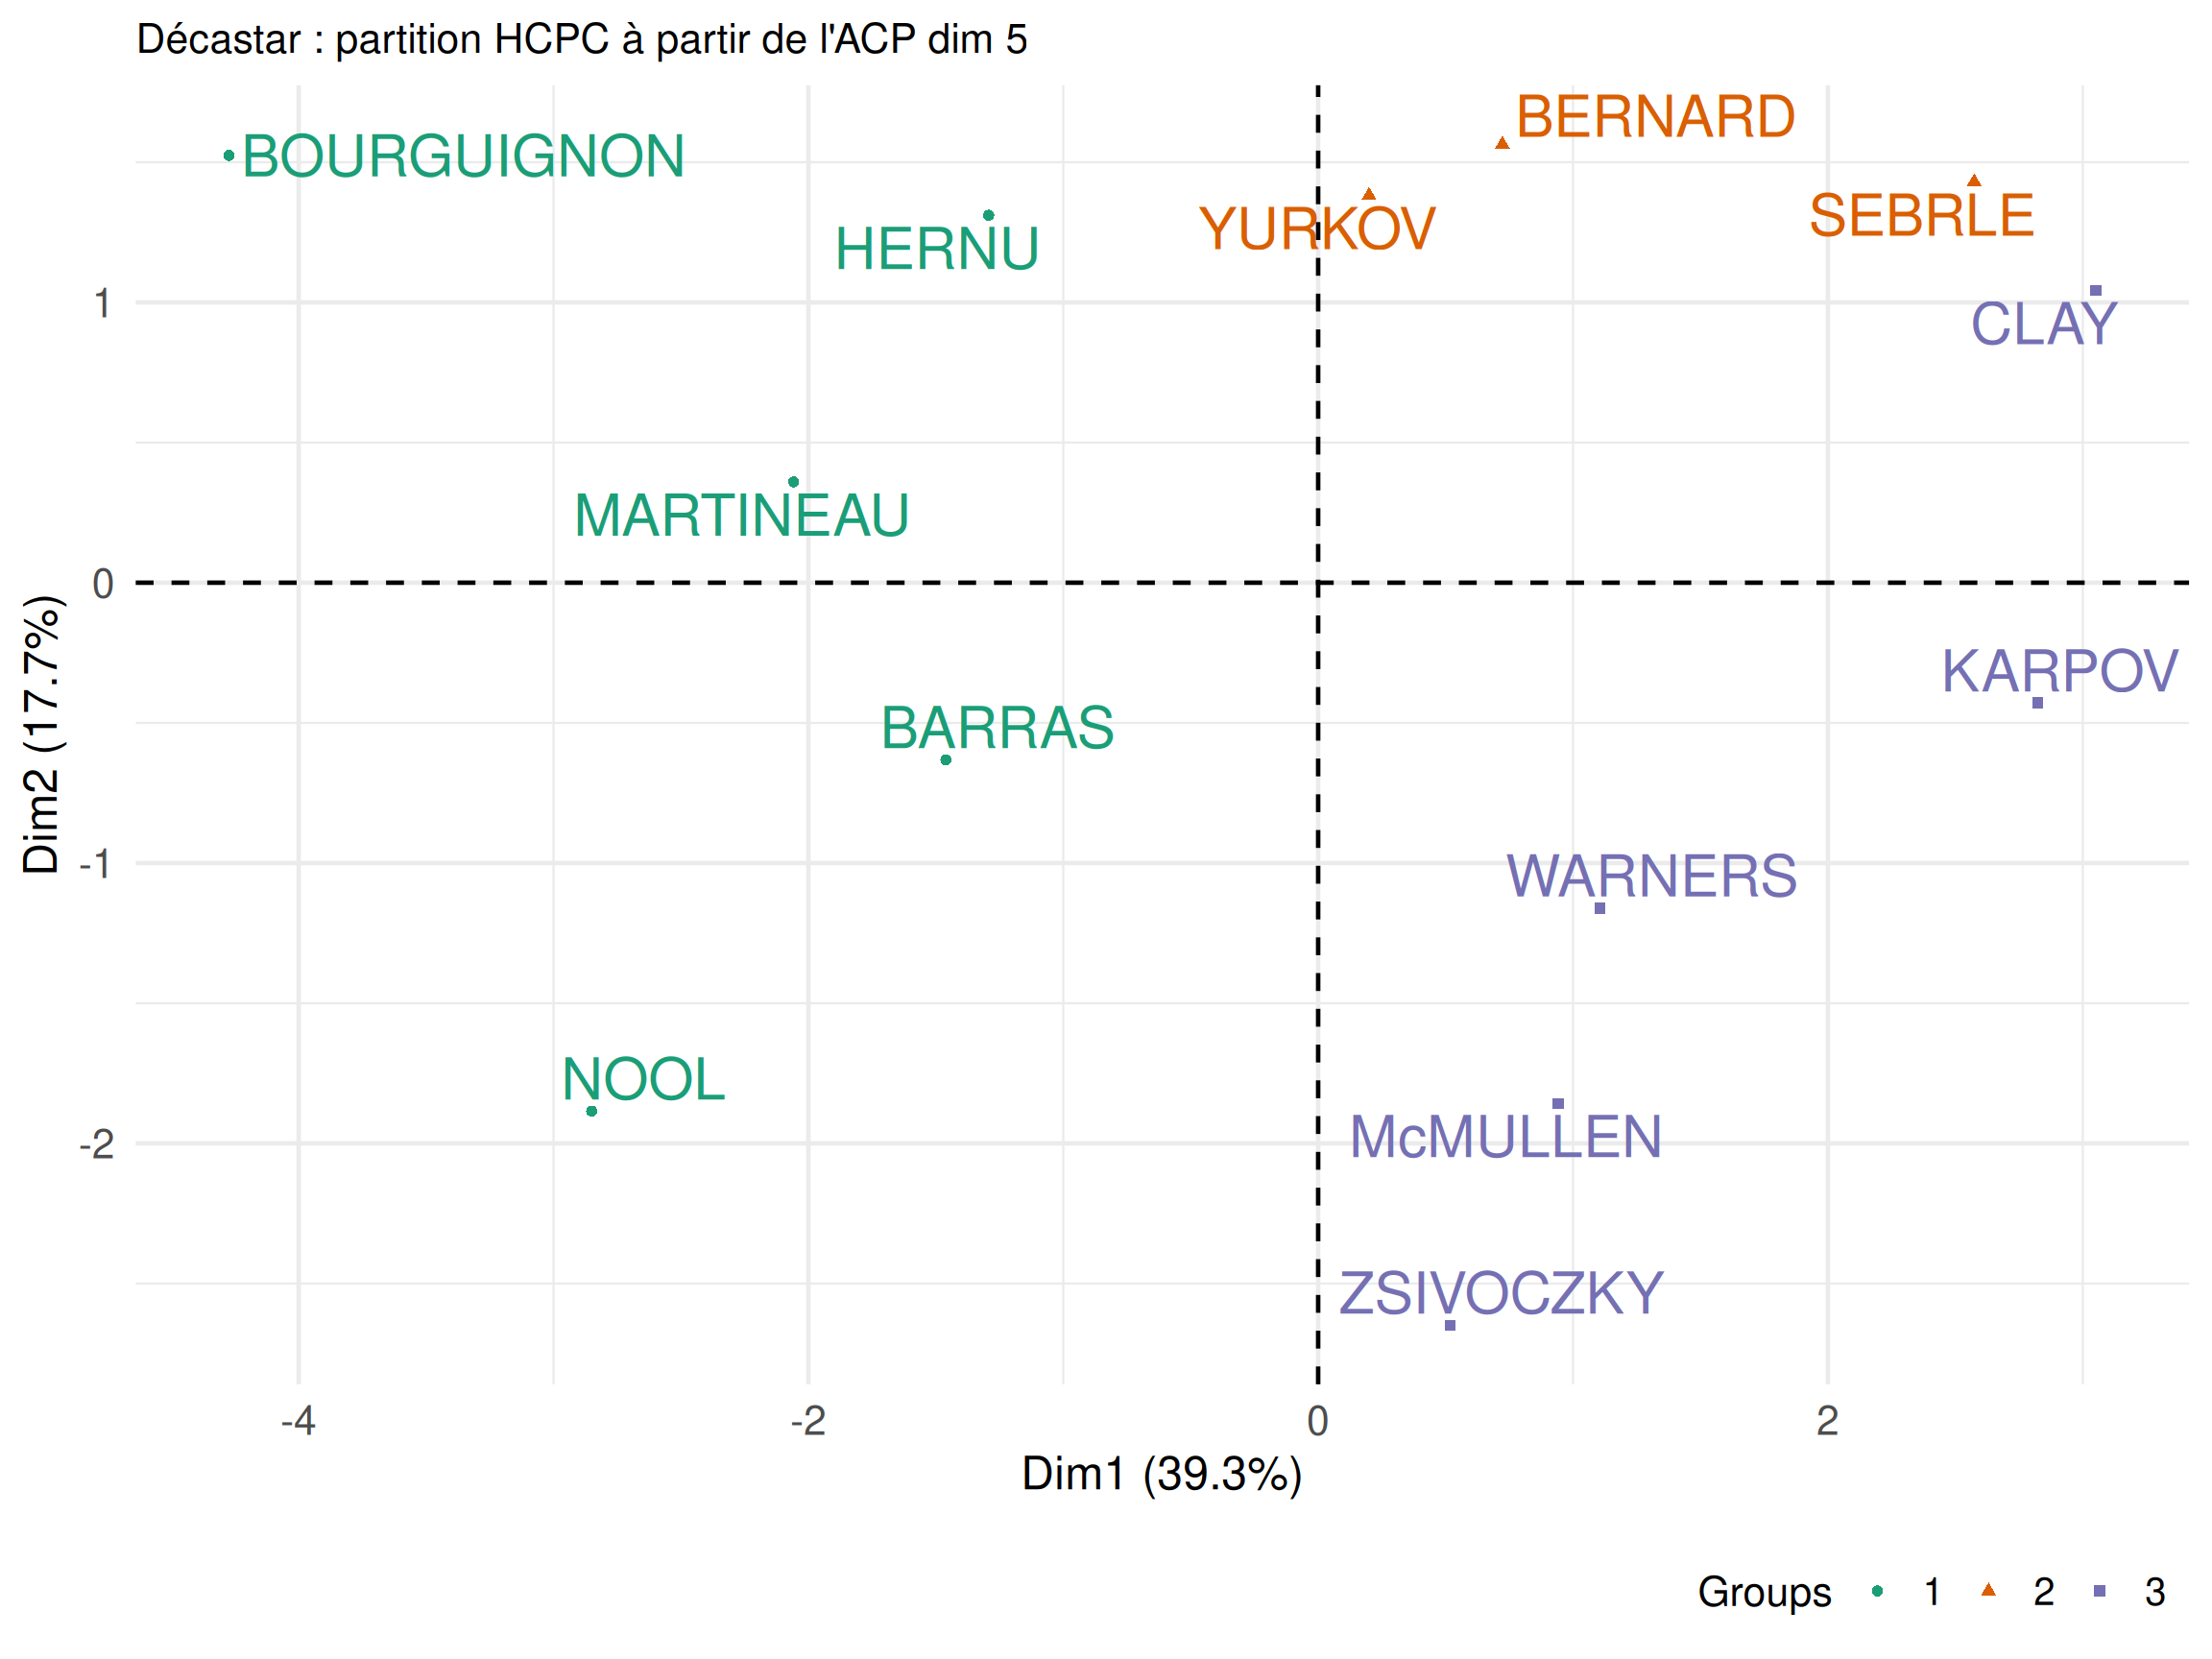
- On retient une partition en 3 classes. Les individus sont représentés sur le premier plan factoriel de l’ACP. Commentez ce graphique.
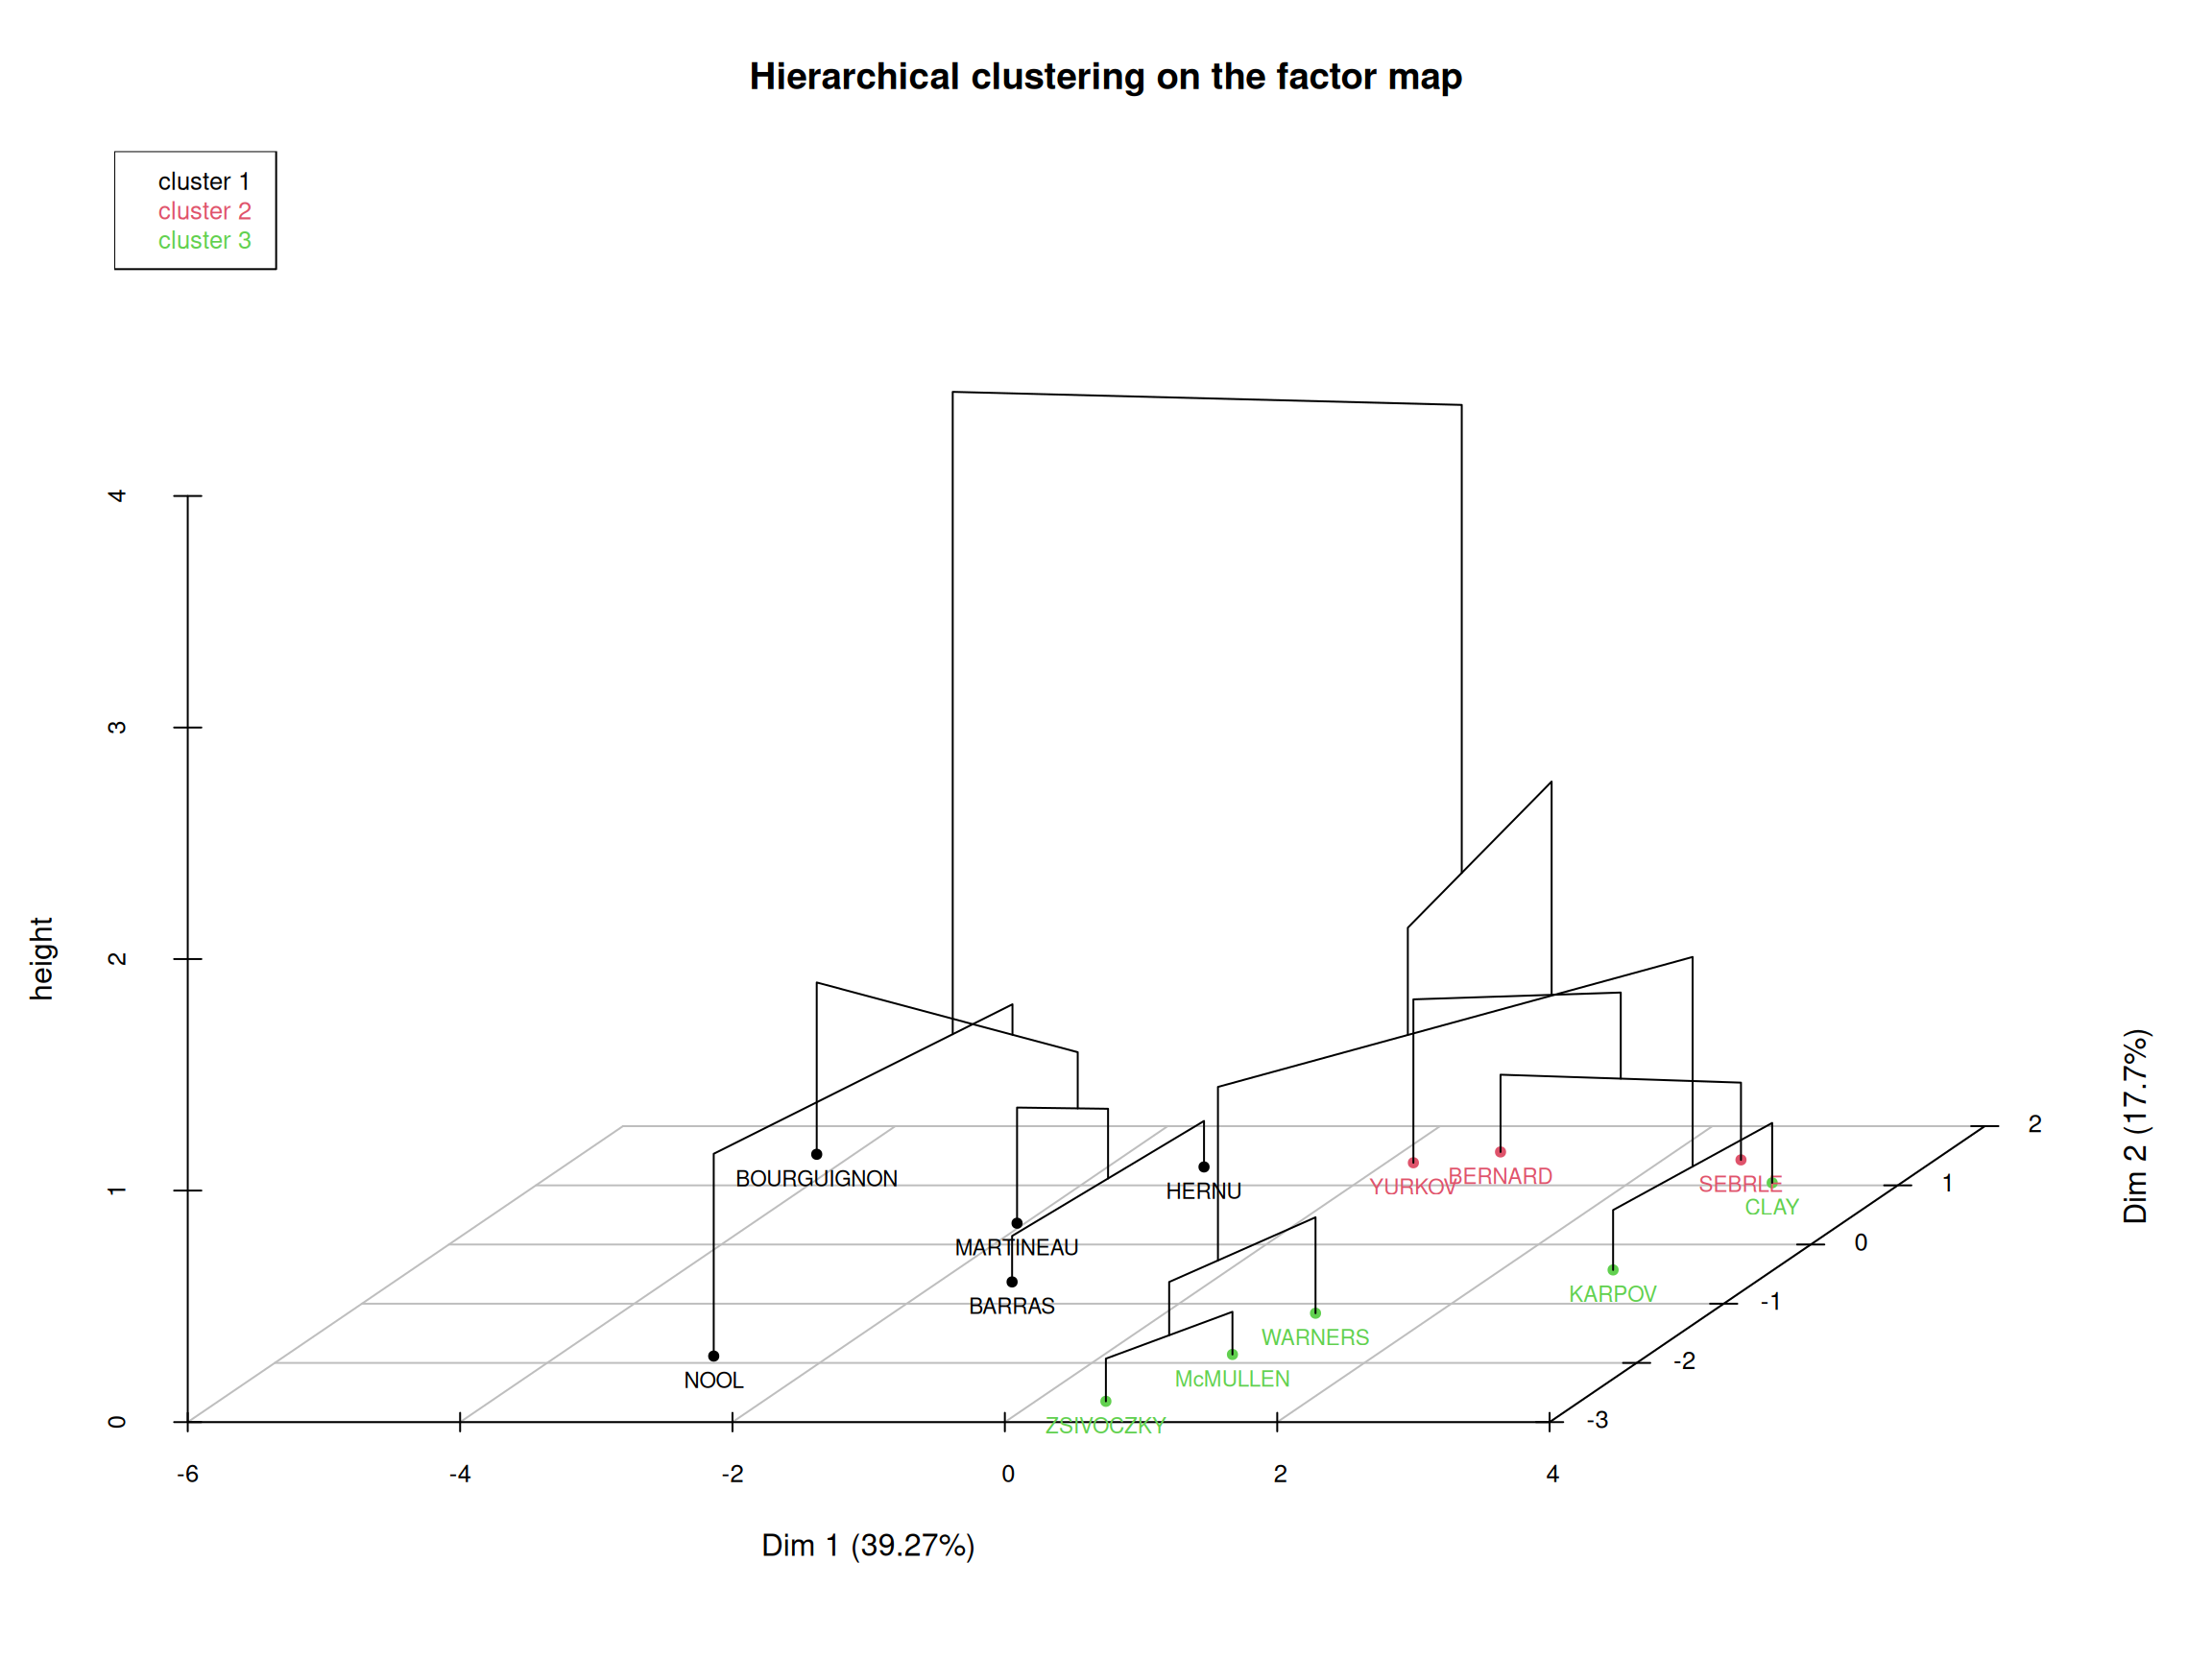
- On rappelle ci-dessous le tableau des valeurs propres associées à l’ACP.
> print_table(deca.acp$eig)| eigenvalue | percentage of variance | cumulative percentage of variance | |
|---|---|---|---|
| comp 1 | 3.114 | 31.144 | 31.144 |
| comp 2 | 2.027 | 20.267 | 51.411 |
| comp 3 | 1.390 | 13.903 | 65.314 |
| comp 4 | 1.321 | 13.206 | 78.520 |
| comp 5 | 0.861 | 8.610 | 87.129 |
| comp 6 | 0.566 | 5.656 | 92.785 |
| comp 7 | 0.497 | 4.966 | 97.751 |
| comp 8 | 0.108 | 1.079 | 98.831 |
| comp 9 | 0.094 | 0.940 | 99.771 |
| comp 10 | 0.023 | 0.229 | 100.000 |
Si l’on souhaitait refaire la CAH après une réduction de dimension, combien de directions principales proposeriez-vous de conserver ? Commentez le graphique ci-dessous.
2 Exercice 2. Choisir le nombre K de partition
La méthode K-means se calcule simplement à l’aide de la fonction kmeans
> data("iris")
> head(iris)
Sepal.Length Sepal.Width Petal.Length Petal.Width Species
1 5.1 3.5 1.4 0.2 setosa
2 4.9 3.0 1.4 0.2 setosa
3 4.7 3.2 1.3 0.2 setosa
4 4.6 3.1 1.5 0.2 setosa
5 5.0 3.6 1.4 0.2 setosa
6 5.4 3.9 1.7 0.4 setosa> # Remove species column (5) and scale the data
> iris.scaled <- scale(iris[, -5])
>
> ## Classification selon 3 groupes par kmeans des données normalisées
> data.km = kmeans(iris.scaled, centers = 3)L’objet data.km ainsi construit contient les éléments suivants
clusterindique le groupe auquel appartient chaque observation deiris.scaledcentersdonne la position des centres de chaque groupewithinscontient la somme des carrés des écarts intra-classe de chaque classebetweenscontient la somme des carrés des écarts inter-classe
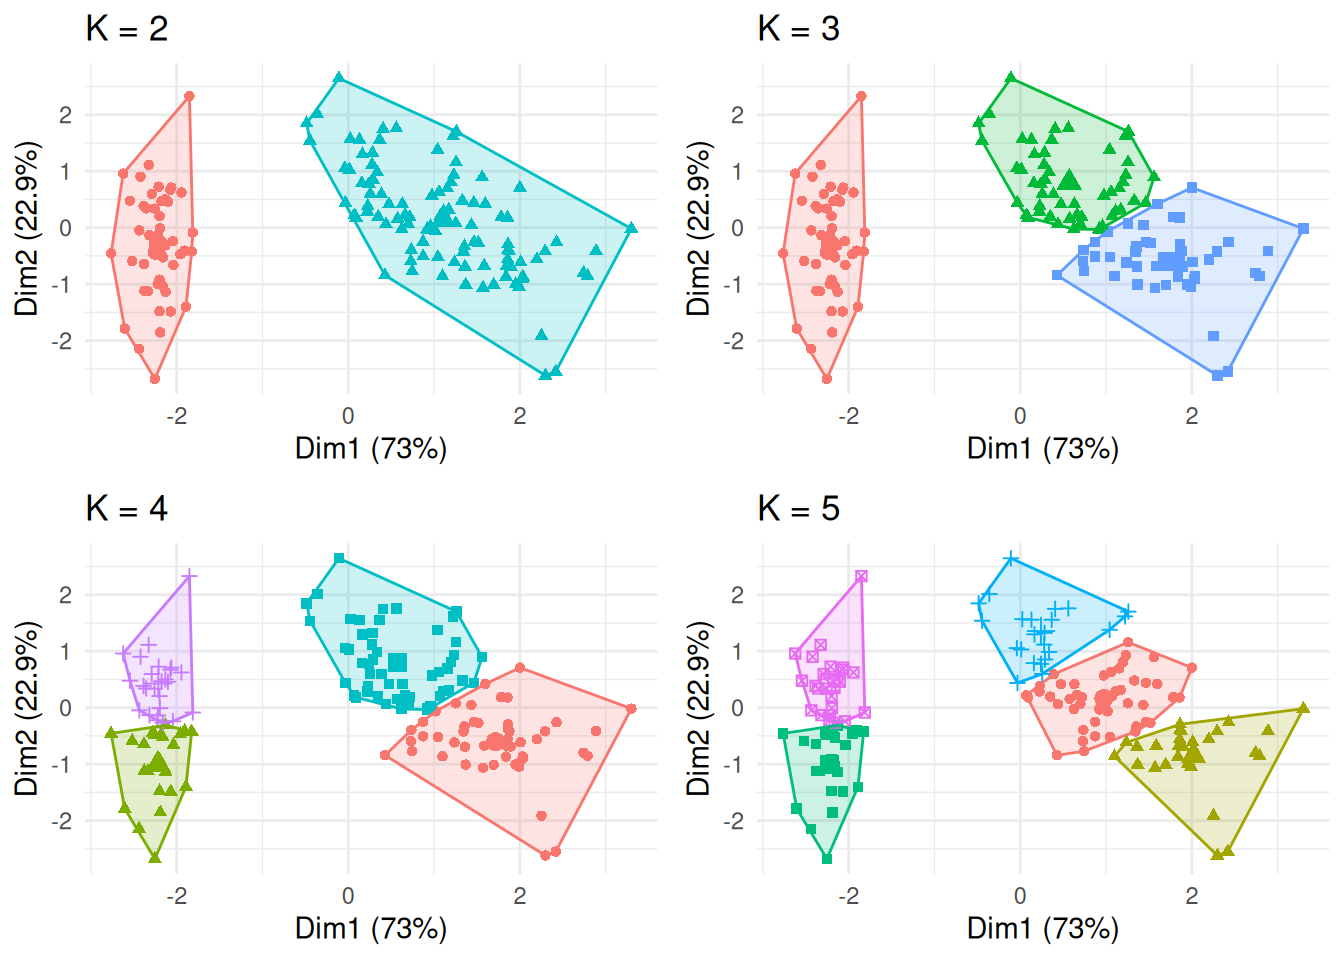
- On effectue le regroupement par K-means pour K = 2, 3, 4, 5 et comparer l’évolution de ces valeurs:
- De nombreuses méthodes ont été développées pour choisir K de manière automatique. On peut par exemple effectuer d’abord une CAH pour nous aider dans notre choix, mais il n’est parfois pas possible d’effectuer une CAH (notamment en présence de très grands volumes de données). La fonction
factoextra::fviz_nbclust()fournit 3 outils principaux pour aider à prendre une décision sur la valeur de K. Déterminer le choix optimal dans chacun des cas.
- Étude de l’inertie intra-classe
wss: on applique K-means pour différentes valeurs de K, et pour chaque résultat on calcule l’inertie intra-classe. En traçant ces valeurs, on obtient (nécessairement) une courbe décroissante en fonction de K, et l’on peut alors repérer sur cette courbe un coude, c’est-à-dire un point d’inflexion à partir duquel la vitesse de décroissance s’atténue fortement.
> fviz_nbclust(iris.scaled, kmeans, method = "wss") 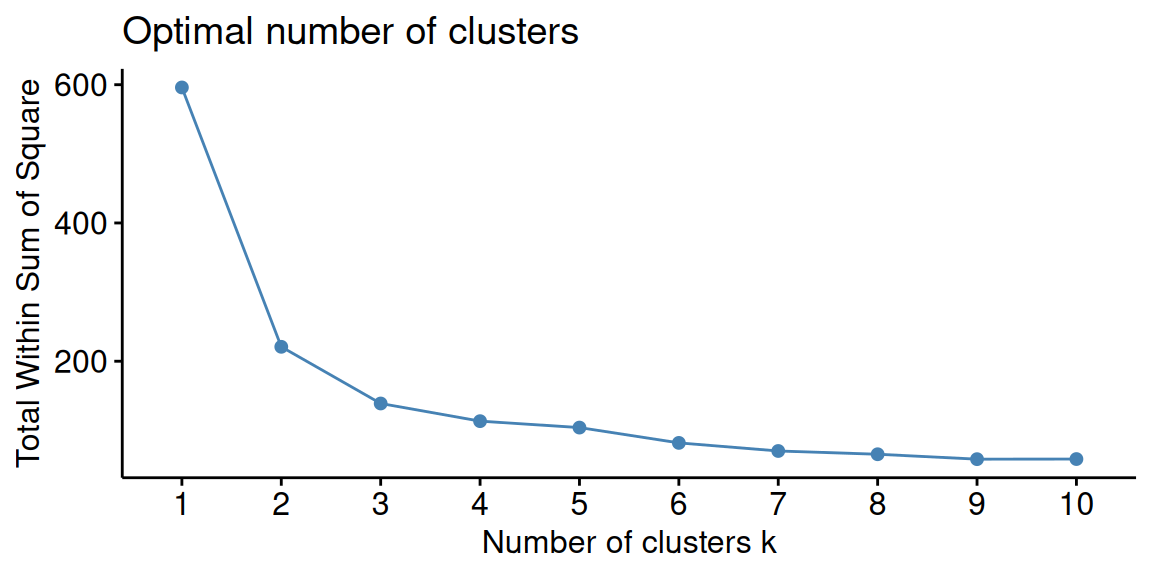
- Analyse de la silhouette
silhouette: cette approche mesure la qualité de la partition en évaluant à quel point chaque objet est bien classé dans son groupe par rapport aux autres groupes (cohésion interne vs séparation externe). On cherche la valeur de K qui maximise la largeur moyenne de la silhouette. Le graphique de la silhouette permet d’étudier l’homogénéité des groupes formés : plus la valeur de la silhouette est élevée, meilleure est la qualité de la classification. Dans le cas où il y a des mesures négatives, cela incite à repenser la classification de l’observation en question.
Soit a(i) la dissimilarité moyenne entre l’observation i et tous les autres points du cluster auquel i appartient (si i est la seule observation de son cluster, on pose s(i) := 0 sans calculs supplémentaires). Pour tous les autres clusters C, soit d(i, C) la dissimilarité moyenne de i à toutes les observations de C. La plus petite de ces valeurs est notée : b(i) := \min_{C} d(i, C) Cette quantité représente la dissimilarité entre i et son cluster “voisin”, c’est-à-dire le plus proche cluster auquel il n’appartient pas. Enfin, le coefficient de silhouette est défini par : s(i) := \frac{b(i) - a(i)}{\max(a(i), b(i))}
On a donc des valeurs allant de -1 (possible mauvais classement) à 1 (possible bon classement). On trace l’évolution de la silhouette globale (via sa moyenne sur l’ensemble des observations) en fonction de K et l’on choisit la valeur de K maximisant cette courbe.
> fviz_nbclust(iris.scaled, kmeans, method = "silhouette")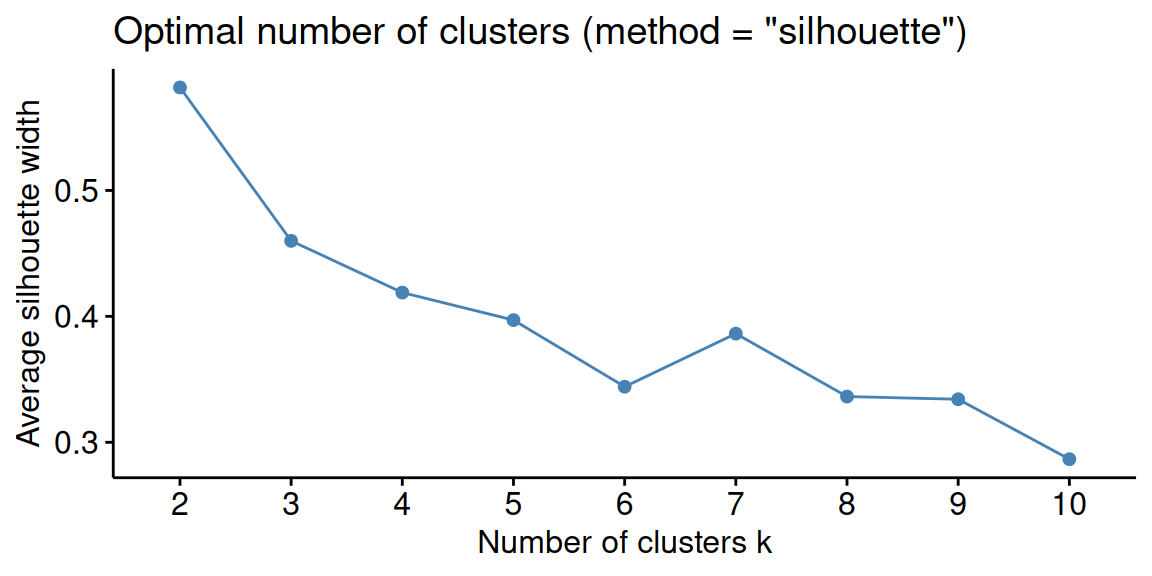
  cluster size ave.sil.width
1       1   47          0.35
2       2   53          0.39
3       3   50          0.64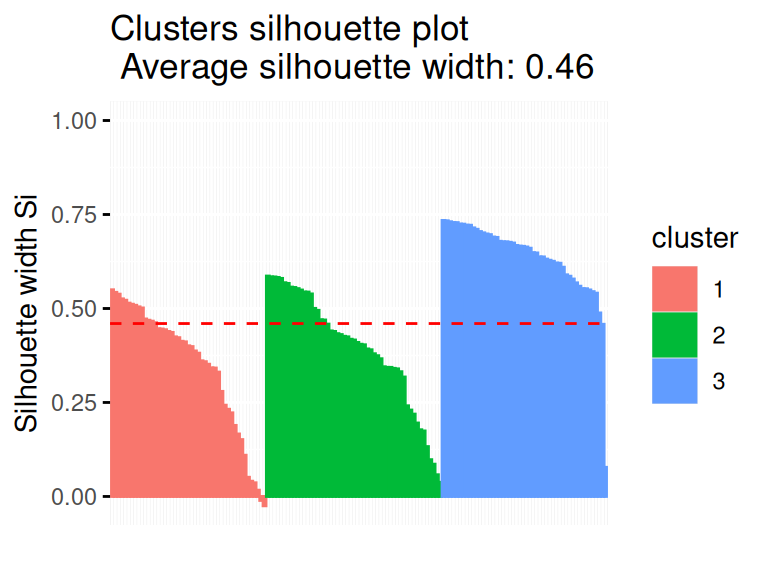
- Méthode du Gap
Gap Stat: On reprend le calcul des variances de la première méthode (inertie intra-classe), et on compare les valeurs obtenues à celles qu’on obtiendrait en appliquant les K-means sur des données de référence sans structure de regroupement (par exemple, uniformément réparties). On trace alors l’évolution de la différence obtenue (le gap), qui est censée croître puis se stabiliser ou décroître avec K (dans le sens où la variabilité sur données uniformes décroît de manière prévisible jusqu’à une certaine valeur de K). On choisit alors la valeur optimale de K en maximisant cette statistique (ou en utilisant la règle de l’écart type de Tibshirani).
> fviz_nbclust(iris.scaled, kmeans, method = "gap_stat")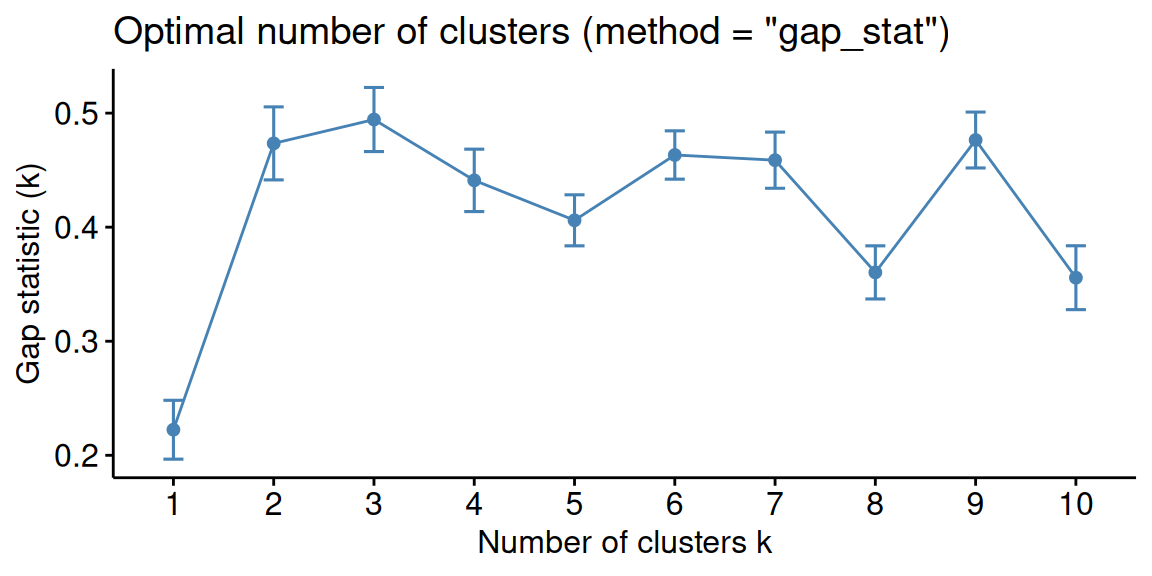
3 Exercice 3. Démonstration du théorème de Huygens
Soient x_1, \dots, x_n des observations dans \mathbb{R}^p partitionnées en K groupes disjoints \mathcal{G}^{(1)}, \dots, \mathcal{G}^{(K)}.
Démontrer la décomposition de l’inertie (théorème de Huygens) : \frac{1}{n} \sum_{i=1}^n d(x_i, g)^2 = \frac{1}{n} \sum_{k=1}^K \sum_{x_i \in \mathcal{G}^{(k)}} d(x_i, g^{(k)})^2 + \sum_{k=1}^K \frac{n_k}{n} d(g^{(k)}, g)^2
où g = \frac{1}{n} \sum_{i=1}^n x_i est le centre de gravité global, n_k = |\mathcal{G}^{(k)}| désigne l’effectif du groupe k et g^{(k)} = \frac{1}{n_k} \sum_{x_i \in \mathcal{G}^{(k)}} x_i est le centre de gravité du groupe k.